自增人生

何以解忧,唯有 i++

采用QEMU制作的最小linux顺利启动后,就该为其写内核模块了,所以这一节就是热热身:

  • 学习如何通过vscode搭建linux驱动开发环境
  • 编写第一个内核模块helloworld
  • 初识linux内核模块机制

警告:在开始阅读下文之前,务必确保自己的linux内核被交叉编译过,并顺利生成zImage。

Ubuntu+VSCode的驱动开发环境搭建

2015年底微软用自己的行动向世人证明,在IDE领域,你大爷还是你大爷,即便是Visual Studio Code这种所谓的代码编辑器,都可以傲视一堆所谓功能强大的集成开发环境。随着近几年的更新迭代,vscode在c/c++的开发方面也不逊色于vs了(我个人感受),在GO、Web、C/C++以及很多非主力语言,它都是我的首选。因此,之后的内核模块代码编写,自然也少不了这利器。(一不小心闲话扯多了)

进入正题,vscode安装好之后,务必安装微软官方扩展——C/C++,这个扩展的好处是提供语法高亮、智能补全、提示、调试等核心功能,剩下的酷炫功能及教程自行看官网。对于驱动来说,主要是方便代码补全和接口提示,以提高编写效率。
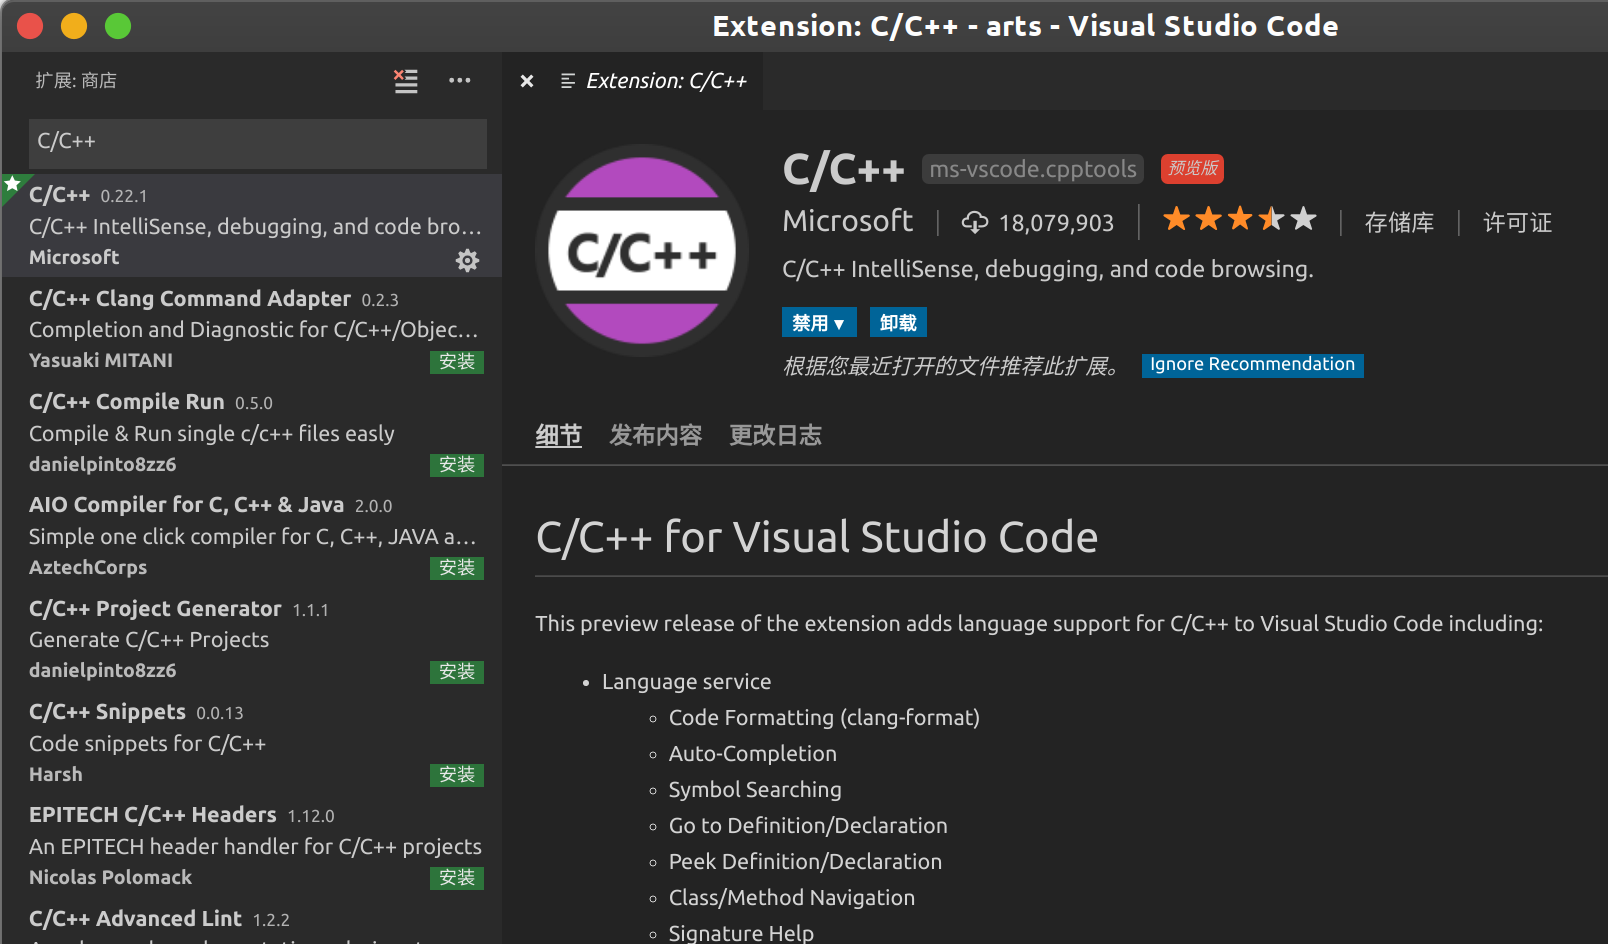
vscode及其扩展安装完毕后,开始写代码吧,创建第一个驱动源码——hello.c

1
2
3
$ mkdir ~/varm/drivers/hello
$ cd ~/varm/drivers/hello
$ touch hello.c

先别急着写代码,vscode扩展需要我们告诉它从哪里解析头文件,以分析和自动补全你想要的接口形式,所以:

1
2
~/varm/drivers/hello$ mkdir .vscode # 创建vscode当前项目配置目录
~/varm/drivers/hello$ touch .vscode/c_cpp_properties.json # 创建C/C++扩展的配置

打开刚创建的json配置文件,并把下方的内容拷贝进取,不过要注意includePath部分,里边的路径是我自己的环境,说白了就是要告诉vscode从哪里能够找到linux内核以及arm架构所需的头文件位置,这个需要根据自己的实际情况作调整。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
{
"configurations": [
{
"name": "Linux",
"includePath": [
"${workspaceFolder}/**",
"/opt/varm/linux-5.0.3/include",
"/opt/varm/linux-5.0.3/arch/arm/include",
"/opt/varm/linux-5.0.3/arch/arm/include/generated",
"/opt/varm/linux-5.0.3/include/uapi"
],
"defines": [
"__KERNEL__",
"__GNUC__"
],
"compilerPath": "/usr/bin/gcc",
"cStandard": "c11",
"cppStandard": "c++17",
"intelliSenseMode": "clang-x64"
}
],
"version": 4
}

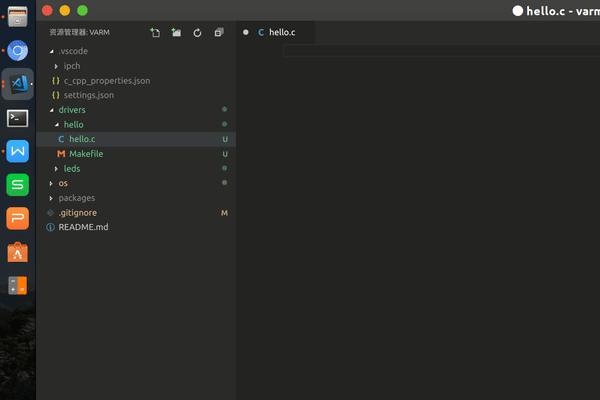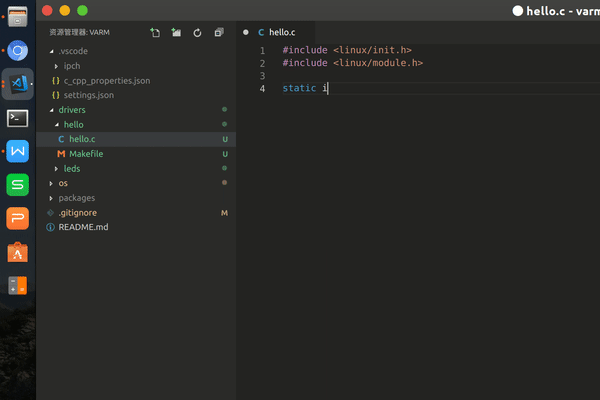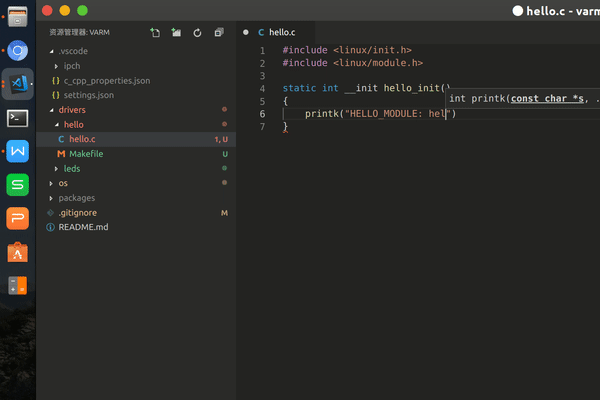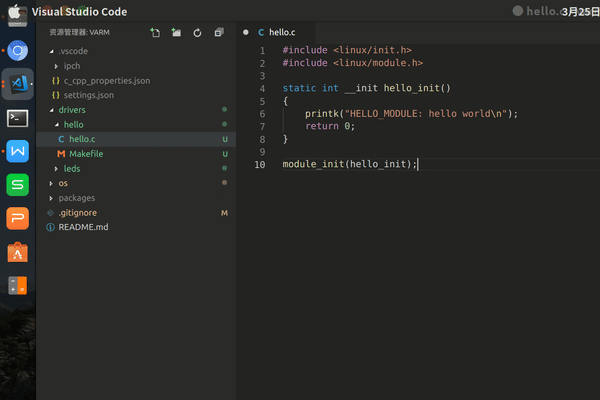
好了,现在可以愉快地写代码了,就像下图这样,vscode驱动开发环境配置结束。
第一个linux内核驱动

先看代码!

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
#include <linux/init.h>
#include <linux/module.h>

// 内核加载时触发
static int __init hello_init(void)
{
printk("HELLO_MODULE: hello world\n");
return 0;
}

// 内核卸载时触发
static void __exit hello_exit(void)
{
printk("HELLO_MODULE: goodbye\n");
}

// 真正向内核制定该模块出入口
module_init(hello_init);
module_exit(hello_exit);

// 各种版权、扩展信息声明,无关紧要
MODULE_LICENSE("GPL v2"); // 开源许可证
MODULE_DESCRIPTION("my first kernel module"); // 模块描述
MODULE_ALIAS("HelloWorld"); // 模块别名
MODULE_AUTHOR("Philon"); // 模块作者

上述代码可以说非常简单了,我们定义了两个函数hello_init/hello_exit都只是简单打印了一句话,并通过module_init/module_exit分别告诉内核,当加载/卸载该模块的时候执行对应的函数。

为什么不用printf函数打印

一是因为printf是C的标准库函数,依赖于C的动态库文件,比如/lib/libc.so.6文件,内核就不应该直接去访问这个文件。
二是因为模块是运行在内核层,而非用户层,printf要通过用户文件系统把内容输出到文件,同样是第一条理由,所以printk也就是指通过内核输出。

不光printk,内核开发中还会遇到很多k结尾的函数,比如mallock,都是因为标准C库的原因,不能直接调用,但其功能及接口形式与标准库几乎一样。

两个函数前__init/__exit意味着什么

这两个是修师符,即使不添加也不会有任何表面上的区别,但建议加上!

__init表示该函数是初始化函数,在最终生成的模块文件中,这段代码会被强制放到.init.text段区,当模块加载完毕后,该区所有分配的内存资源都会被释放。
__exit表示该函数是退出函数,如果你的驱动并非“模块”,而是直接编译进内核,那么被此修饰的函数显然是多余的(编译到内核中的驱动是无法卸载的),因此该函数不会被链接,以缩小镜像大小。

关于开源与许可证

这部分会涉及到非常多的法律问题和风险,一般来说如果一个驱动没有声明GPL协议,在加载时会收到内核被污染的警告,逼死强迫症。但是对于我等初学小白而言,可以暂时不用考虑这部分内容。但如果是工作中的代码或涉及商业机密,建议还是谨慎对待,毕竟不是每个程序员都善于打官司。

编译并“运行”驱动

第一步:编译

linux的内核模块编译是必须依赖内核源码的,这就是为什么文章一开始注明必须确保linux内核已经交叉编译过的原因。而内核模块需要通过Makefile来指定是编译到内核中,还是以模块形式存在,也就是下面的第一行obj-m=hello.o。

1
2
3
4
5
6
7
8
9
10
11
12
# 模块驱动,必须以obj-m=xxx形式编写
obj-m = hello.o

# 指定内核源码目录及交叉编译环境
KDIR = /opt/varm/linux-5.0.3
CROSS = ARCH=arm CROSS_COMPILE=arm-linux-gnueabihf-

all:
$(MAKE) -C $(KDIR) M=`pwd` $(CROSS) modules

clean:
$(MAKE) -C $(KDIR) M=`pwd` $(CROSS) clean

除了第一行需要留意下以外,其他都是常规Makefile语法,本文主要关注驱动开发,其他语法规则什么的就不废话了。直接make一下就能看到hello.ko的出现,这就是最终内核模块。

第二步:拷入根文件系统

虽然linux内核模块是运行在内核层的,但其加载、卸载、访问、操作等策略性的事物是完全交由用户层来管理,驱动仅仅负责实现和提供设备访问机制。所以现在需要把编译好的ko文件拷贝到之前制作好的根文件系统镜像中——rootfs.ext3。

目前我们的linux最小系统还很简陋,没有网络共享,因此最粗暴的方式就是挂载镜像——复制——启动系统。

1
2
3
$ sudo mount -o loop ~/varm/os/rootfs.ext3 /mnt
$ sudo cp ~/varm/drivers/hello/hello.ko /mnt
$ cd ~/varm/os && ./power_on # 完成拷贝,启动系统

第三步:加载/卸载

记住linux最简单的管理内核命令:

  • insmod,加载内核模块
  • rmmod,卸载内核模块

正如下图所示,hello.ko和预期一样分别在加载和卸载模块时打印出了相应的内容。
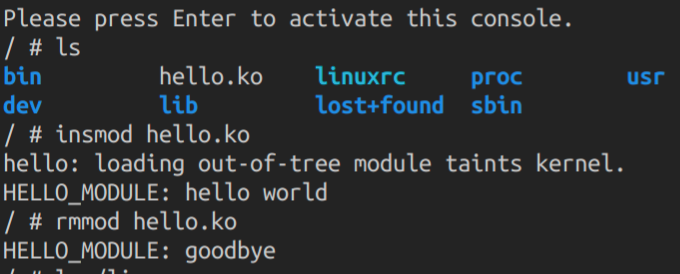
关于提示loading out-of-tree module taints kernel.主要是由于该模块并不存在设备树中,想想第一节的make dtbs,所以这个警告无关紧要。关键是第一个内核模块版本的HelloWorld顺利通过验收,鼓掌!

以上是本节的实操,结束!


以下是Linux内核知识,GO!

虚拟文件系统

对于Linux“玩家”而言,文件系统(File System)是非常简单的概念,比如Windows的NTFS、macOS的APFS、Linux的Ext4、U盘的Fat32等等,所以文件系统就是对物理存储空间的逻辑抽象和数据组织管理的机制,根据不同的操作系统或存储介质演化出了如今众多的文件系统类型,但不论如何,我们口中的文件系统泛指对存储介质的数据管理系统。而Linux更是将这种思想发挥到了极致——一切皆文件。

有了文件系统,我们可以非常直观地open、close、read、write任何文件,访问任何目录。但你有没有想过,硬盘里的“文件或目录”归根结底只是一些二进制数据,只要格式化就消失了。而计算机周围的键盘、鼠标、显示屏、打印机、摄像头等,这些可是真实设备啊,每种设备的操作方式都不同,意味着每增加一个设备,Linux内核就要专门为其开发一种API给用户访问,就算Linux社区的黑客们不嫌烦,我等芸芸众猿也学不过来呀。

为此,Linux社区孕育了“把每个设备抽象成一个文件”的想法,这样不论什么新设备都可以用open、close、read、write函数访问,而组织管理这些设备文件的,自然就是设备文件系统,比如/dev、/sys等目录,我暂且把它们称作设备文件系统。

此外,操作系统管理着很多进程,这些进程同样千奇百怪,如何让用户非常方便地访问呢?抽象成文件系统啊,每个进程都抽象成文件,直观地摆到用户面前,比如/proc目录,我暂且把它称作进程文件系统。

还有,我们的电脑是可以网络通信,通过http、ftp等,网络上的资源也是让人眼花缭乱,怎么能直观呢?浏览器是个不错的选择,但对于只有命令行的黑客呢?抽象成网络文件系统吧。

回首,掏再看看我们的根文件系统,最多把它称为硬盘文件系统。

所以那么多的文件系统摆在我的面前,Windows没有好好珍惜,只是甩给用户一堆ABCDEFG盘。Linux不想这样,它不希望用户觉察到文件系统的存在,让用户觉得“去他妈的文件系统,老子只是打开了一个文件夹”。所以为了解决不同文件系统的“共生”问题,虚拟文件系统诞生了!

重新认识dev、sys、proc目录

上边扯了一堆“废话”介绍有关虚拟文件系统的概念,换而言之,不要简单的认为/dev、/sys、/proc这几个根目录仅仅是个目录,否则接下来的设备驱动开发会看得云里雾里。

挂载proc文件系统

在介绍之前先启动之前用qemu做好的Linux系统,然后尝试用ps看一下进程😁

1
2
3
4
5
6
7
8
9
10
11
12
~/varm/os$ ./power_on.sh
Booting Linux on physical CPU 0x0
Linux version 5.0.3 (philon@philon-matebook) (gcc version 7.3.0 (Ubuntu/Linaro 7.3.0-27ubuntu1~18.04)) #1 SMP Thu Mar 21 20:44:13 CST 2019
...省略各种打印信息...
Please press Enter to activate this console.

/ # ps
PID USER TIME COMMAND
ps: can''t open '/proc': No such file or directory
/ # ls
bin lib lost+found usr
dev linuxrc sbin

看,一个最简单的进程查看命令居然出错了,提示找不到/proc目录,简单啊——创建这个目录再试试:

1
2
3
4
5
6
/ # mkdir /proc
/ # ps -a
PID USER TIME COMMAND

/ # ls /proc/
/ #

错误提示不见了,但依然什么进程都没有,连系统进程都没有,这怎么可能,proc目录下空空如也…

呵呵,根本原因出在我们把/proc当作一个普通目录来处理了,正如前边所说,Linux会把所有的进程抽象为文件来组织管理,所以核心问题是以上命令并没有真正去挂载procfs,所以正确的做法是这样:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
/ # mount -t proc proc /proc # 把proc文件系统挂载到/proc目录下
/ # ls /proc
1 28 815 diskstats net
10 29 828 driver pagetypeinfo
11 3 829 execdomains partitions
... # 这样就可以访问到真正proc文件系统的所以进程ID内容了

/ # ps
PID USER TIME COMMAND
1 0 0:01 init
2 0 0:00 [kthreadd]
3 0 0:00 [rcu_gp]
4 0 0:00 [rcu_par_gp]
... # 系统进程也可以正常查看了

挂载sysfs文件系统

和proc文件系统道理一样,sysfs顾名但不要思义,顾名是指这个文件系统肯定是挂载到/sys目录,不要思义是指sysfs不是为了呈现系统而生的。

sysfs最开始Linux为了更好地以文件/目录形式在用户层展现设备树和驱动的结构及关联才开发的,其实就是从/proc/sys中剥离出来,所以最初其实这个文件系统名为ddfs(Device-Driver-FS)。后来这个文件系统和驱动模型被证明在其他子系统中也大有作为,就干脆叫做sysfs。

说那么多,要搞清楚,/sys这个目录主要是为了清晰呈现设备、驱动、类型之间的关联(如果你不嫌烦可以一个个子目录翻了看看,其中有很多符号链接)。今后写驱动,可能会频繁地访问该目录。

好了,把sysfs也挂载起来吧

1
2
3
4
5
/ # mkdir /sys
/ # mount -t sysfs sysfs /sys
/ # ls /sys
block class devices fs module
bus dev firmware kernel power

/dev与udev

其实如果你不较真儿的话,/dev可以就是个目录,但常见的Linux版本中更喜欢把它挂载到tmpfs文件系统,说白了就是个虚拟硬盘,临时内存区而已。说它可以是个普通目录的意思,是说该目录下的所有文件,理论上来说都是在用户层完成的,非内核在管理。设备和驱动真正被内核管理的地方是刚说的sysfs。这也是为什么在很多嵌入式Linux文件系统的启动脚本里,会有各种mknod命令出现。

那/dev目录存在的意义是什么?很简单——设备描述符。任何设备被Linux抽象的符号链接最终都应该放在这里,比如我们要访问串口,不是区/sys目录下找XX设备,而是应该找/dev/ttyXXX设备描述符。

udev是什么?解释之前先了解另一个东东——devfs,这货其实就是最开始内核来管理设备的文件系统了,也就是说刚开始一个u盘插入后各种驱动加载、指定设备号、创建文件描述符等等工作都由它完成。出发点自然是很好,但封闭的弊端就是不灵活。此时udev注意到这些缺点,而且认为什么加载驱动、创建文件符号这些事情完全可以留给用户曾作,画蛇添足干嘛,所以udev才取代了devfs。

简单来说,udev也类似于文件系统管理着/dev目录,但运行在用户态,通过监听uevent,动态为插拔设备做各种驱动加载、创建文件描述符等,但这些行为是根据用户层的匹配规则完成的。

小结一下

  • vscode和c/c++扩展可以很好地支持Linux驱动的代码编辑
  • 内核模块编译依赖于内核源码,并通过obj-m=xxx.o指定模块名称
  • insmod xxx.ko加载一个内核模块
  • rmmod xxx卸载一个内核模块
  • /dev /proc /sys目录其实是三个文件系统

Fulfill Your Ambitions with Open Source

不用你来做开发工作就能实现你雄心勃勃的软件开发白日梦,想必也是极好的。也许你正在为某大型保险公司开发软件时,你宁可在Google、Apple、Microsoft、或你自己的初创公司工作,准备搞一个大动作。你再也不用为那些你根本不关心的系统去开发软件。

幸好,有一个办法可以解决你的问题:开源。那里有成千上万的开源项目,而且其中多数都很活跃,为你提供任何你想得到的软件开发经验。如果你热爱这种开发操作系统的创意,去给其中的某个操作系统项目帮忙吧。如果你想为音乐软件、动画软件、密码学、机器人、PC游戏、大型多人在线游戏、移动电话、或任何(软件)工作,基本上你一定能找到一个符合你兴趣的项目。

当然,天下没有免费的午餐。你不得不放弃你的自由时间,因为你很可能无法在工作日为一款开源的视频游戏工作——你仍然要向你的雇主负责呀。还有,很少有人能通过给开源项目做贡献而获得收入——少部分可以但绝大多数不行。你应该愿意放弃一些自由时间(少玩会视频游戏、少看会电视,你又不会死)。在开源项目上你工作越努力,你就越能尽早意识到作为程序员你真正的理想。但也要注重你的劳动合同——有些老板可能会限制你可以贡献的内容,即使在你的私人时间。此外,你需要小心不要违反与版权、专利、商标、商业机密等相关知识产权法。

开源可以为那些躁动不安的程序员提供巨大的机遇。首先,你可以看到他人是如何对你感兴趣的那些项目实施解决方案的——你会从阅读他人代码中获益匪浅。其次,你可以为这些项目贡献你的代码和想法——不是每个精彩创意都会被接受,但你可以通过研究解决方案和贡献代码学到很多东西。第三,你会遇见对你的软件充满热情的优秀人才——这些开源友谊能持续一辈子。第四,假设你是一个贡献者,你可以在你真正感兴趣的领域积累实际经验。

开源入门实在是太容易了。这里有大量关于你需要的工具的相关文档(比如源码管理、编辑器、编程语言、构建工具等)。首先找出你想要研究的项目,然后学习项目所采用的工具。多数情况下项目文档都比较少,不过最好的学习方式应该是自己查阅代码。如果你想参与,你可以提供帮助文档。或者你可以从义务写测试代码开始。当然这听起来没那么让人兴奋,但实际上你会因为给别人的程序写测试代码而比那些从来不活跃的人学习得更快。写测试代码,真正好的测试代码。找出bug、修复建议、交朋友、为你喜欢的软件工作,实现你软件开发的抱负。

真的是一不小心翻开了此书,然后决定读完的。我之前一直避免去读“创业类”的书籍,一是纸上谈兵居多,二是“老子现在没打算创业”,所以此类书籍大多会给我留下空洞的映像。《创业维艰,如何完成比艰难更难的事》要比我所读过的任何讲述创业的书籍内容都实在的多,也许就是书中说的那个原因——大部分管理书籍都是教你怎么在顺境中当好CEO,而不提怎么应对逆境。不过作者(本·霍洛维茨)就比较苦逼了,在他打理Opsware的8年时间里,只有3天是顺利的,剩下的日子每天都刀口舔血,也正是因此才得以让我们看到光鲜亮丽的CEO身后的孤独与焦虑。

阅读全文 »

问:作为嵌入式软件工程师,你会写驱动吗?
答:会呀,我会控制gpio输出把LED点亮!😂

我想这是我扎根嵌入式软件开发多年的尴尬之处——不太会写驱动!所以,我决定系统地学习一下这个领域,一来是工作需要弥补我在驱动层的空白,二来自己也想全面了解Linux内核机制。基本上我主要通过《Linux设备驱动开发详解,基于最新的Linux4.0内核》以及《Linux设备驱动程序》作为主要参考教材(毕竟手上就这两本书)。

废话结束


为了避免繁琐地硬件环境搭建,学习过程尽可能基于虚拟的arm开发板,既能保证环境统一,又能快速上手👍。

另外,我个人的“战果”全部放在git仓库:github/philon/varm

个人开发环境:

  • 宿主机:Ubuntu 18.04
  • 开发板:qemu+vexpress-a9
  • 编辑器:visual studio code
  • 编译器:arm-linux-gnueabihf-gcc

关于如何安装Linux虚拟机以及交叉编译环境的搭建这里就不写了,网上教程一大堆。所以从现在开始,阅读下文的前提是:Linux、arm-linux-gcc、各种源码编辑器环境已就绪。

好,下面亲手动手,来做一块arm开发板😅。

ARM虚拟机——QEMU

QEMU是一款免费开源且跨平台的虚拟机,可以虚拟各种架构的处理器,和vmware/virtualbox不同,我们更喜欢用它来仿真ARM环境,即一款ARM虚拟机。

第一步:下载并安装qemu

1
2
3
4
5
6
7
# macOS用户
$ brew install qemu

# Ubuntu用户
$ sudo apt-get install qemu

# Windows用户麻烦把门口的小黄车挪一挪

第二步:选择一款arm

装好后可以通过以下命令qemu支持哪些arm处理器(开发板):

1
2
3
4
5
6
7
8
9
10
11
$ qemu-system-arm -M help
akita Sharp SL-C1000 (Akita) PDA (PXA270)
ast2500-evb Aspeed AST2500 EVB (ARM1176)
borzoi Sharp SL-C3100 (Borzoi) PDA (PXA270)
...
vexpress-a15 ARM Versatile Express for Cortex-A15
vexpress-a9 ARM Versatile Express for Cortex-A9 # 👈没错就它了
...
witherspoon-bmc OpenPOWER Witherspoon BMC (ARM1176)
xilinx-zynq-a9 Xilinx Zynq Platform Baseboard for Cortex-A9
z2 Zipit Z2 (PXA27x)

选中自己喜欢的“硬件”环境后,理论上就可以“上电”了,不过且慢——操作系统还没装呢!所以接下来很重要的一步就是制作自己的Linux系统镜像。

制作Linux系统镜像

做嵌入式Linux的人都知道,一个完整的嵌入式Linux操作系统基本分为三大块:

  • u-boot:上电初始化并引导内核
  • kernel:Linux内核
  • rootfs:根文件系统,busybox

由于qemu可以直接引导内核,所以这里暂且略过u-boot的移植。其它两个源码建议选择“稳定版”,别给自己找麻烦。

第一步:移植内核

从linux内核官网下载源码并解压(我嘞个去!Linux都步入5.0时代了,果断下载),然后根据以下命令移植:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
# 0. 可能需要安装flex、bsion,如果之前没装的话,否则编译镜像时会出错
$ sudo apt install flex bison

# 1. 解压源码并进入目录
~/varm/os$ tar xf linux-5.0.3.tar.xz && cd linux-5.0.3

# 2. 将内核设置为vexpress的配置,即vexpress-a9开发板
make ARCH=arm CROSS_COMPILE=arm-linux-gnueabihf- vexpress_defconfig

# 3. 编译内核镜像zImage
make ARCH=arm CROSS_COMPILE=arm-linux-gnueabihf- zImage -j8

# 4. 编译其它驱动模块,制作rootfs时候要用
make ARCH=arm CROSS_COMPILE=arm-linux-gnueabihf- modules -j8

# 5. 编译设备树
make ARCH=arm CROSS_COMPILE=arm-linux-gnueabihf- dtbs -j8

根据上述命令完成kernel移植之后,所有需要的镜像及其相关文件全部放在<kernel_dir>/arch/arm/boot中:

1
2
3
4
5
6
7
8
# zImage和dts就是真正需要的东西
~/varm/os/linux-5.0.3$ ls arch/arm/boot/
Image bootp deflate_xip_data.sh install.sh
Makefile compressed dts zImage

# 为了之后操作方便,我把它们放到varm/os目录下
~/varm/os/linux-5.0.3$ cp -rf arch/arm/boot/zImage .. # 内核镜像
~/varm/os/linux-5.0.3$ cp -f arch/arm/boot/dts/vexpress-v2p-ca9.dtb .. # 设备树描述

第二步:启动内核

既然有了内核镜像文件,就可以先小试牛刀了,qemu走起!

1
2
~/varm/os/linux-5.0.3$ cd ..
~/varm/os$ qemu-system-arm -M vexpress-a9 -m 512M -kernel zImage -dtb vexpress-v2p-ca9.dtb -nographic

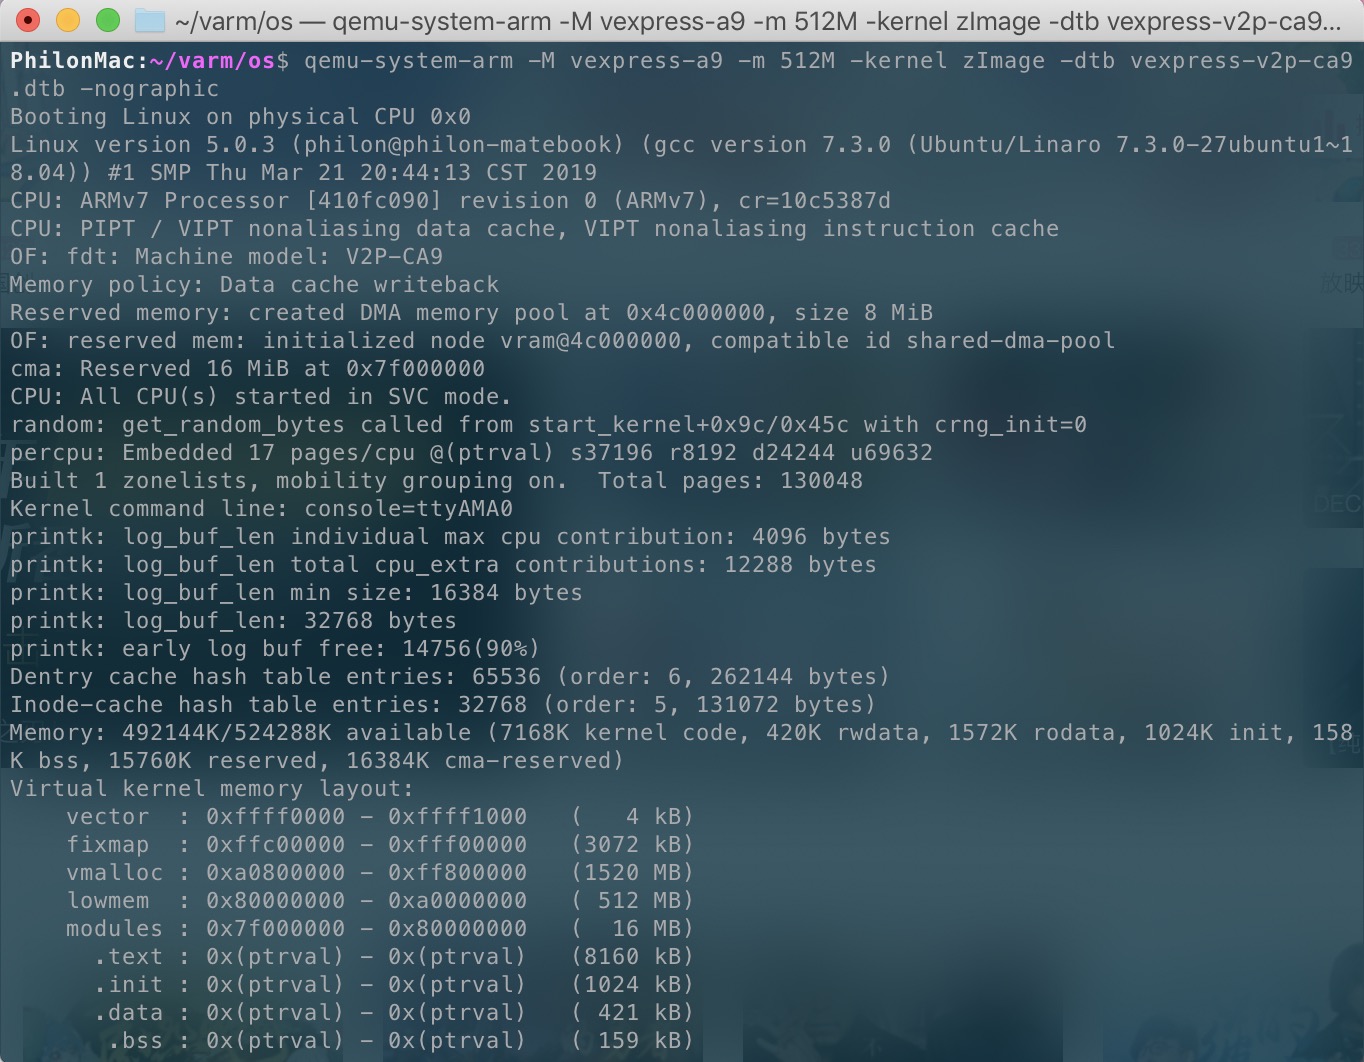
可以看到kernel被成功启动了,但由于没有文件系统,内核向你抛出了一个异常。
此外,上述命令比较长,简单解释下:

1
2
3
4
5
6
qemu-system-arm \ # 虚拟机启动
-M vexpress-a9 \ # 指定开发板为vexpress-a9
-m 512M \ # 配置虚拟机内存为512M
-kernel zImage \ # 指定内核镜像文件
-dtb vexpress-v2p-ca9.dtb \ # 指定设备树文件
-nographic \ # 不需要图形界面(LCD)

还有一点,quem启动后是一个独立进程,所有的Ctrl+C和其他中断信号都会被这个进程来接,程序无法关闭,最好的办法是新建一个终端,用kill来杀!

1
2
$ killall qemu-system-arm
# 也可以是ps先看qemu的pid,在用kill <pid>来杀,我只是觉得那样麻烦

第三步:移植busybox

同样先从busybox官网把源码包下载下来,然后开始移植:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
# 1. 解压源码并进入目录
~/varm/os$ tar xf busybox-1.30.1.tar.bz2 && cd busybox-1.30.1

# 2. 选择默认配置
make ARCH=arm CROSS_COMPILE=arm-linux-gnueabihf- defconfig

# 3. 编译busybox
make ARCH=arm CROSS_COMPILE=arm-linux-gnueabihf- -j8

# 4. 安装busybox到./_install目录
make ARCH=arm CROSS_COMPILE=arm-linux-gnueabihf- install

# 顺利完成上述步骤后,可以在`busybox/_install`
# 目录下看到各种`usr lib bin`之类的文件系统结构
# 这就是rootfs的雏形了,现在还需要在此基础上做些加工

# 5. 为了方便之后操作,一样将_install目录放到varm/os下,并重命名为rootfs
~/varm/os/busybox-1.30.1$ mv _install ../rootfs

第四步:制作根文件系统rootfs

busybox已经生成了linux常用的一些命令和简单的目录结构,现在还差两个东西:

  • busybox的命令执行是依赖于交叉编译工具的动态库的,所以要把动态库放入rootfs
  • 需要给文件系统一些默认的设备描述符,否则你想让它往哪输出
1
2
3
4
5
6
7
8
# 1. 拷贝根文件系统的“必需品”到rootfs目录
~/varm/os/busybox-1.30.1$ cd ..
~/varm/os$ mkdir rootfs/lib # 创建系统库文件存放目录
~/varm/os$ cp -P /usr/arm-linux-gnueabihf/lib/*.so* rootfs/lib # 拷贝gcc动态库

# 2. 创建设备目录以及4个tty终端和调试串口
~/varm/os$ mkdir rootfs/dev # 创建设备描述符目录
~/varm/os$ for i in 1 2 3 4; do sudo mknod rootfs/dev/tty$i c 4 $i; done

第五步:创建rootfs镜像

所谓镜像可以理解为一张虚拟的光盘,存放操作系统。但玩过树莓派的同学应该都知道它的存储其实就是一个SD卡,那好,我们就创建一张虚拟的SD卡给qemu加载。

1
2
3
4
5
6
7
8
# 1. 生成镜像文件(虚拟SD卡),且大小为32M
$ dd if=/dev/zero of=rootfs.ext3 bs=1M count=32 # 创建一个32M的空文件
$ mkfs.ext3 rootfs.ext3 # 将该文件格式化为ext3

# 2. 挂在镜像到/mnt目录,并将rootfs目录导入其中
$ sudo mount -o loop rootfs.ext3 /mnt
$ sudo cp -r rootfs/* /mnt
$ sudo umount /mnt

现在整个rootfs.ext3镜像制作完成,再加上zImage内核镜像,可以起飞了可以开机正常加载了,重新调整一下qemu的启动命令:

1
~/varm/os$ qemu-system-arm -M vexpress-a9 -m 512M -kernel zImage -dtb vexpress-v2p-ca9.dtb -sd rootfs.ext3 -nographic -append "root=/dev/mmcblk0 console=ttyAMA0"

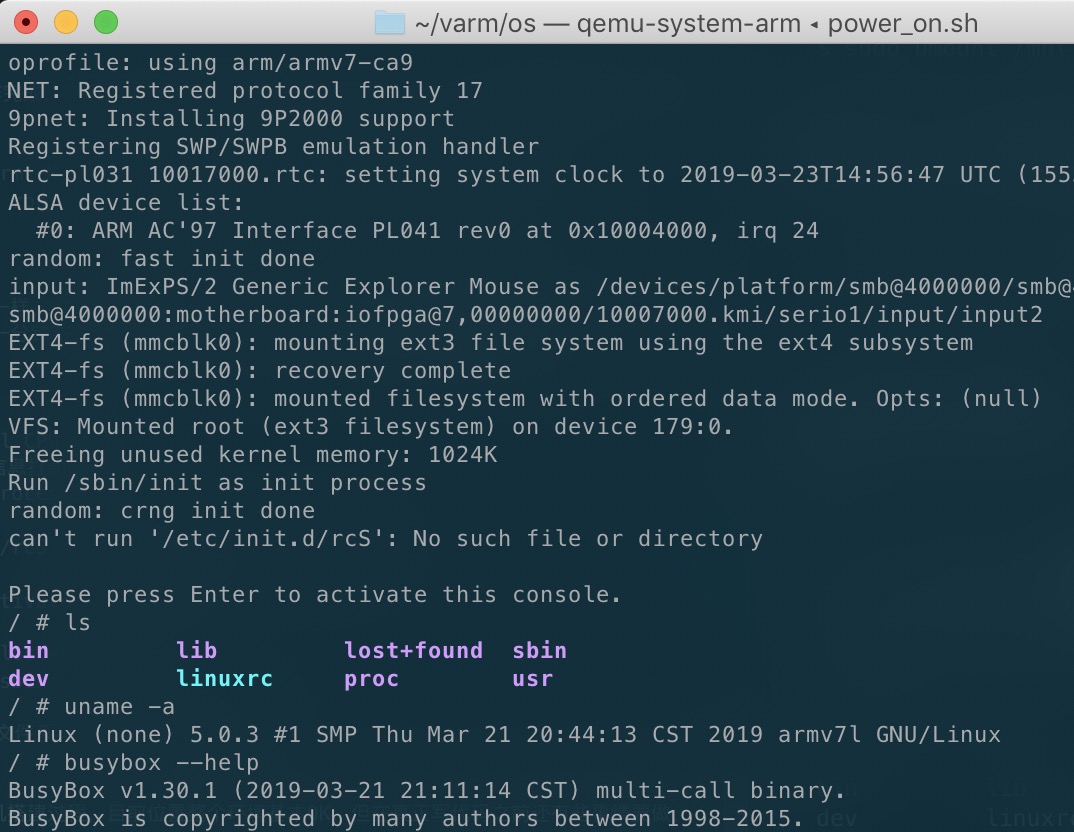
上边的命令大体上和内核启动时一样,主要是增加了-sd rootfs.ext3文件系统的SD卡和对应分区,以确保内核能正确加载文件系统。经过一分钟左右的等待,我们的最小Linux系统成功运行起来了😄:

如果顺利的话内核会成功挂在文件系统,从此可以愉快玩耍了。以上就是整个ArmLinux的虚拟机搭建过程,目前位置整个环境基本OK,但在真正写代码之前还有些事情要做,总之等遇到了再查缺补漏。

小结一下

  • QEMU是一款虚拟机,可以虚拟常见的通用处理器架构,包括ARM,支持很多开发板模拟
  • vexpress-a9是ARM官方出的一款开发板
  • QEMU可以直接引导内核,因此可以不用移植u-boot

Floating-point Numbers Aren’t Real

在数学科学种,浮点数不是“实数(real)”,尽管他们在很多编程语言中被称为real,比如Pascal和Fortran。实数是无限精度并连续无损的;浮点数被限制了精度,所以它们是有限的,类似于“表现不好”的整数,因为它们在整个范围没有均匀间隔。

举个例子,把2147483647(32位int的最大值)分配给一个32位float变量(名为x),然后打印。你会得到2147483648。现在打印x - 64,仍然是2147483648。现在打印x - 65你将得到2147483520!为什么?因为这两个浮点数之间的间隔是128,浮点运算会舍入到最近的浮点数。

(译注:类似于分辨率,128是浮点类型在内存中能表现的最小单位——间隔)

IEEE浮点数是基于基数为2的科学记数法的固定精度数:1.d1d2…d(p-1)x2^e,p代表精度(float是24,double是53)。两个连续的数之间的间隔应为2^(1-p+e),可以安全近似于ε|x|,ε表示机器的epsilon(2^(1-p))。

知道相邻浮点数的间隔可以帮你避免数字类型的错误。比如,你要处理迭代计算,例如搜索方程的根,要求找出比超过系统能表达精度更高的数字是没有意义的。确保你要求得的差值没回比间隔更小,否则会进入死循环。

自从浮点数成了实数的近似值以来,就存在不可避免的错误。这种错误被称作四舍五入,会导致意外的结果。当你去减一个近似值时,例如高位数相互抵消,所以在浮点运算的结果,低位的有效数字(被四舍五入的那部分)被提升到了高位,本质上污染了进一步的相关计算(被称作涂抹)。你需要细致地观察你的算法,以阻止这种灾难性的消除。为了说明,考虑用二次公式求解方程x²-100000x+1=0。由于表达式-b+sqrt(b²-4)中的操作数近似相等,你可以先计算出r1=-b+sqrt(b²-4),再求得r2=1/r1,因此任何二次方程,ax2+bx+c=0,这个结果满足r1r2=c/a。

涂抹可以以更精妙的方式运行。假设一个库通过1+x+x²/2+x³/3!+…的公式计算e^x,这只适用于x是正数,但想想当x为一个很大的负数时会发生什么。偶数次方结果是大的正数,减去奇数次方的幅度甚至不会影响结果。这里的问题是,正项在数字中的地位要比真实答案影响更大。结果就是趋向于无穷大!这里的解决方案也很简单:给一个负x,计算e^x=1/e^|x|。

不言而喻,你不应该将浮点数用于金融类应用——就是像python和C#语言中的十进制类。浮点数用于高效的科学计算。但失去了精度,性能就毫无价值,所以请记住舍入错误的来源及相应的代码。

2008年的时候我正在上大学,我所在的城市房价还盘旋在五六千的样子,作为愤青之年的我们,最为津津乐道的一个话题——一个人不吃不喝多少年才能买得起房?那时掐指一算,大概要二十年吧。

毕业后,我本可以向父母伸手凑个首付,从此当个幸福快乐的房奴,但毕竟处在一个桀骜不驯的年纪,励志要凭自己的本事买房。所以我努力工作赚钱,升职加薪,可房价也是个不服输的“励志哥”,我的工资和房价就像赛道里的运动员,一路你追我赶。坚持了多年的“长跑”后,我投降了,不是我没毅力,真的是速度不够快。(虽然攒够了首付钱,但为了减轻房贷压力,还是向家里借钱了)

阅读全文 »

在很多软件开发中,单元测试是最为基础且最有效的软件质量保证手段。我个人是搞C语言开发出身,想当年,printf打天下,从来就没怕过谁。而后来逐步接触C#/Java等企业级的编程语言,才明白单元测试对功能模块和业务的重要性,加之现在IDE的强悍,查错效率也是极高的。

GO语言也提供了相对完善的测试框架——testing包,其实这类内容网上一搜一大把,作者却将其作为本书的最后一章单独提出来,想必他也清楚“测试”对软件开发而言的地位。

所以,就我个人而言,最后一章不难,主要是学习如何全方位地做软件测试,即testing包和go test命令的使用,这些内容很重要,包括:

  • 如何创建单元测试
  • 如何模拟生产环境
  • 如何测试性能

GO语言单元测试

  1. 确保文件名为xxx_test.go的形式
  2. 确保单元测试函数为TestXXX(t *testing.T)的形式
  3. 使用go test直接运行所有的测试文件

此外,本书还按场景提供了不同的测试方法,主要有:

  • 基础单元测试:最常规的,按照预期值测试
  • 表组测试:多个输入值,多个预期值测试
  • 模仿调用:本地模拟服务端,排除网络问题,仅测试业务
  • 端点测试:针对类似RESTful结构,测试某个单一路径功能

为了说明这些测试是如何实现和使用的,我们需要先声明两个全局变量,后续的所有代码中都会调用:

1
2
3
4
5
// 如果测试通过,在行尾打✅
const checkMark = "\u2713"

// 如果测试失败,在行尾打❌
const ballotX = "\u2717"

1.基础单元测试

以下测试是按照书中的举例写的,主要是对某个url发起http请求,正常情况下服务端都会响应200表示OK,但也可能会出现404找不到,或者干脆连接超时的情况出现。这段代码中的url是书中提供的,会出现404或超时:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
func TestSingle(t *testing.T) {
url := "http://www.goinggo.net/feeds/posts/default?alt=rss"
statusCode := 200

t.Log("测试下载: ", url)
{
t.Logf("\t预期收到状态码为: %d", statusCode)
{
resp, err := http.Get(url)
if err != nil {
t.Fatal("\t\t调用http.Get()发起请求失败: ", ballotX, err)
}
t.Log("\t\t调用http.Get()发起请求", checkMark)

defer resp.Body.Close()
if resp.StatusCode == statusCode {
t.Logf("\t\t收到状态码 %v %v", resp.StatusCode, checkMark)
} else {
t.Errorf("\t\t收到状态码 %v %v", resp.StatusCode, ballotX)
}
}
}
}

// ---------- go test -v ----------
=== RUN TestSingle
--- FAIL: TestSingle (3.69s)
unit_test.go:18: 测试下载: http://www.goinggo.net/feeds/posts/default?alt=rss
unit_test.go:20: 预期收到状态码为: 200
unit_test.go:26: 调用http.Get()发起请求 ✓
unit_test.go:32: 收到状态码 404 ✗

如上述代码可以看到,所谓单元测试,主要是通过执行某些过程,比对其结果是否符合预期。这里发起http请求只是过程,而断言http.Get()函数会成功以及服务端响应200是预期。从执行结果可以看到,请求成功了,但服务端响应状态码为404,不符合预期,测试失败。

注意t.Log的使用,基本是从log包定制的一套日志实例,主要是能在每行日志前增加测试的源文件及行号,便于错误定位。

另外,源码中每个t.Log后都带有一对大括号,这个不是必须的,因为几乎每个日志内容里都含有\t缩进符,估计作者的本意是为了直观地表示缩进吧。

2.表组测试

很多时候我们都需要用大量且不同的参数来测试某个函数的执行结果是否都符合预期,而这就是表组测试。其实表组测试没有什么特别的地方,无非就是把测试参数装进数组里,通过遍历测试每一个。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
func TestMulti(t *testing.T) {
urls := []struct {
url string
code int
}{
{
"https://www.github.com",
http.StatusOK, // 200
}, {
"https://www.github.com/philon/123",
http.StatusNotFound, // 404
},
}

t.Log("测试访问一组URL,并检查状态码是否正确")
{
for _, u := range urls {
t.Logf("\t对'%s'发起请求,预期状态码为: %d", u.url, u.code)
{
resp, err := http.Get(u.url)
if err != nil {
t.Fatal("\t\t发起请求失败: ", err, ballotX)
}
t.Log("\t\t发起请求成功", checkMark)

defer resp.Body.Close()
if resp.StatusCode == u.code {
t.Log("\t\t收到状态码: ", resp.StatusCode, checkMark)
} else {
t.Log("\t\t收到状态码: ", resp.StatusCode, ballotX)
}
}
}
}
}

// ---------- go test -v ----------
=== RUN TestMulti
--- PASS: TestMulti (1.77s)
unit_test.go:52: 测试访问一组URL,并检查状态码是否正确
unit_test.go:55: 对'https://www.github.com'发起请求,预期状态码为: 200
unit_test.go:61: 发起请求成功 ✓
unit_test.go:65: 收到状态码: 200 ✓
unit_test.go:55: 对'https://www.github.com/philon/123'发起请求,预期状态码为: 404
unit_test.go:61: 发起请求成功 ✓
unit_test.go:65: 收到状态码: 404 ✓

如上,把多个测试参数放进一个[]struct{}形式的切片中,并通过for-range循环遍历测试,就是表组测试的最基本用法。剩下的内容和第一节的单元测试没什么不同。

3.模仿调用

前两个例子一直是对某些网站发起请求,如果对面的服务器挂了怎么办?或者我们的服务器根本就还没上线怎么办?模仿调用就是模拟服务端的意思,模拟出一个服务器,对其发起请求,主要测试业务逻辑是否正常。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
// mockServer 创建虚拟http服务
// 默认响应200,并返回一段json数据
func mockServer() *httptest.Server {
f := func(w http.ResponseWriter, r *http.Request) {
w.WriteHeader(200)
w.Header().Set("Content-Type", "application/json")
fmt.Fprintln(w, `{"id": 9527, "login": "philon"}`)
}

return httptest.NewServer(http.HandlerFunc(f))
}

func TestMocking(t *testing.T) {
...
// 在测试函数中将模拟服务器启动
server := mockServer()
defer server.Close()
// 通过server.URL可访问到模拟服务器
resp, err := http.Get(server.URL)
...
}

这段代码没有完,因为除了模拟http服务端的部分,其它都会基础单元测试一样,就不重复了。http服务端模拟主要通过httptest包实现的,把这部分用法搞清楚即可。

4.端点测试

众所周知,RESTFul的基本设计思想就是通过URL资源访问,并以GET|POST|PUT|DELETE|PATCH等请求方法区别不同的业务逻辑,比如:

  • GET /users 获取用户列表
  • PATCH /users/philon/profile 更新用户配置
  • DELETE /users/philon 删除指定用户

所谓的端点也就是访问路径的意思,比如/users、/users/philon这样的路径,并针对不同的请求方法进行测试。

自建http服务端

要完成这部分的演示,需要先自建一个RESTFul的服务端,或者说传统的MVC架构的服务,为了简单说明,这里仅仅实现GET /users获取用户列表的功能。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
// Routes 全局路由映射
func Routes() {
http.HandleFunc("/users", Users)
}

// Users 用户列表控制器
func Users(rw http.ResponseWriter, r *http.Request) {
list := []struct {
ID int `json:"id"`
Name string `json:"username"`
}{
{1234, "张三"},
{4567, "李四"},
{5678, "王五"},
}

rw.Header().Set("Content-Type", "application/json")
rw.WriteHeader(http.StatusOK)
json.NewEncoder(rw).Encode(&list)
}

func main() {
Routes()
log.Println("Http server start listening: ", 4000)
http.ListenAndServe(":4000", nil)
}

上面这段代码通过go run main.go将该服务启动后,可以通过浏览器直接访问http://localhost:4000/users即可看到结果,这里用curl请求也一样:

1
2
3
4
5
6
7
8
$ curl -i localhost:4000/users

HTTP/1.1 200 OK
Content-Type: application/json
Date: Fri, 15 Mar 2019 00:18:13 GMT
Content-Length: 98

[{"id":1234,"username":"张三"},{"id":4567,"username":"李四"},{"id":5678,"username":"王五"}]

如此这般,一个最简单的RESTFul设计风格的http服务端就做好了。但是!!这并不是端点测试的全部,注意Routes()函数里的http.HandleFunc("/users", Users),这才是路由功能的实现,将路径/users只想Users函数。设想一下,如果你把Users相关的服务端的业务代码写完,你会如何测试?搭建http环境——跑服务代码——跑客户端请求代码——看结果?NO,效率太低了。因为只是测试Users函数有没有正确返回json数据,所以可以仿照3.模仿调用的方式虚拟一个http服务器,直接去测试/users路径。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
func init() {
// 初始化路径,给端点测试用
Routes()
}

func TestController(t *testing.T) {
t.Log("测试服务端点")
{
req, err := http.NewRequest("GET", "/users", nil)
if err != nil {
t.Fatal("\t创建请求对象失败 ", ballotX, err)
}
t.Log("\t创建请求对象成功 ", checkMark)

// httptest创建虚拟服务器
rw := httptest.NewRecorder()
http.DefaultServeMux.ServeHTTP(rw, req)

if rw.Code != http.StatusOK {
t.Fatalf("\t收到状态码 %d 不符合预期 %v", rw.Code, ballotX)
}
t.Log("\t收到状态码", rw.Code, checkMark)

users := []struct {
ID int `json:"id"`
Name string `json:"username"`
}{}

if err := json.NewDecoder(rw.Body).Decode(&users); err != nil {
t.Fatal("响应不是json类型的数据 ", ballotX)
}
t.Log("\tJSON反序列化成功 ", checkMark)

if len(users) == 3 {
t.Log("\t用户列表长度检查 ", checkMark)
} else {
t.Log("\t用户列表长度检查 ", ballotX)
}
}
}

小结一下

  • GO语言自带测试框架testing包
  • go test用来运行测试
  • 测试文件必须以_test.go结尾
  • 测试有单元测试、表组测试、模拟测试、端点测试

因为橙子,我知道了褚时健。

刚步入社会的时候,碰巧公司在玉溪有业务,就订购了一车橙子,给每个员工发一箱当福利。那个时候我带着女友(现在的媳妇)在外租房,饭后我们一人吃了一个看似普通的橙子——简直太好吃了!我清晰记得那个夜晚。本来都睡下把被窝捂热了,由于太回味这橙子的味道,我和老婆冒着寒冷爬起来,又吃了4、5个。后来我在《冬吴相对论》里听到一期关于褚时健的节目,但得知大家都把这橙子叫”褚橙“,而它背后的褚时健可谓一生波折,实在了不起。

上周,朋友圈被褚时健逝世的消息刷屏,媒体也铺天盖地报道,或惋惜、或哀叹。当然,也少不了各种是非争议。我无意参与其中,所以选择读一读他的传记,看一看他的一生,以此祭奠这名时代的勇士。

阅读全文 »

Encapsulate Behavior, not Just State

在系统理论中,包含是处理大型复杂系统结构的最有用的架构之一。在软件工程领域,包含和封装的价值已被认可。编程语言的架构,包含通过如子程序和函数、模块、包、类等方式来得到支持。

模块和包用于处理更大层面的封装需求,而类、子程序、函数则处理更多细节层面的事情。近些年我发现,类似乎成了开发人员最难封装的结构之一。一个类拥有3000多行的main方法,或者一个类仅有set/get方法用于它的原始属性的情况并不罕见。这些例子说明开发者还没有充分理解面向对象思想,没有发挥对象建模的优势。对于开发者熟悉的术语POJO以及POCO(Plain Old Java/C# Object),这相当于模型的范例,回归到了面向对象的基础——对象是朴实而简单的,但不是哑巴!

(译注: POJO是指仅有属性及其get/set方法的类,没有任何业务行为,常用于数据库的实体映射,在DDD中是典型的贫血模型)

一个对象要同时封装状态和行为,其中行为由实际的状态定义。设想一个“门”对象。它有四种状态:关着、开着、关上、打开。它提供了两种操作:开和关。基于这些状态,开和关操作将产生不同行为。一个对象的内在特性使得设计过程在概念上变得简单。可以归结为两个简单的任务:给不同的对象分配和委托职责,包括对象间的通信协议。

通过一个例子可以最好的说明在工作中要如何运用。让我们设想有三个类:Customer, Order, 和Item。Customer对象是信用限额与信用验证规则的天然占位符。一个Order对象知道它和Customer的关系,它的addItem操作通过调用customer.validateCredit(item.price())委托实际的信用验证。如果这个方法的后置条件失败,抛出异常并终止交易。

经验不足的面向对象开发者可能会决定把所有的业务规则打包到通常称为OrderManager或OrderService的对象当中。在这些设计中,Order,Customer,Item被用作记录类型。所有的逻辑都是从类里分解出来并捆绑在一个大的、有大量if-then-else构成的程序方法内。这些方法很容易被破坏,而且几乎不可能维护。原因?封装被破坏了呀。

什么是GO语言的标准库?就是放在$GOROOT//usr/local/go/pkg目录下的那些文件,它们由GO语言社区共同维护的,经过良好设计,确保代码稳定且易用。每次发布GO的新版本时,都会将这些库打包成.a静态库文件。

标准库中有非常多的基本功能,不用在为业务开发而重新造轮子,比如我们最熟悉的fmt,以及log、json、http、网络、图像处理、加密算法等等。

本章仅对log、json、io三个包的调用方式及基本原理做总结,乍一看可能会觉得本章只是带着你了解一下几个函数的基本用法,别不以为然,我个人的理解,本章最最最精华的内容就是最后那句话——阅读标准库的代码时熟悉GO语言习惯的好方法。

所以,没事多看看官方文档:http://golang.org/pkg/

定制自己的Logger

日志是每个程序开发最常用的功能了,一般来说C/C++/Java/C#都会有第三方的日志框架实现,用起来都挺顺手。不过,GO语言标准库中已经包含了日志框架——log包,不用再满世界地去比较到底哪个框架好用了。

先来看看log包的基本用法:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
/**
引用自 golang.org/src/log/log.go
const (
Ldate = 1 << iota // 日期: 2009/01/23
Ltime // 时间: 01:23:23
Lmicroseconds // 毫秒级时间: 01:23:23.123123. 覆盖 Ltime.
Llongfile // 完整的源码文件路径及行号: /a/b/c/d.go:23
Lshortfile // 短路径及行号: d.go:23. 会覆盖 Llongfile
LUTC // 如果设置了Ldata或Ltime,采用UTC取代本地时区
LstdFlags = Ldate | Ltime // 标准日志初始值
)
*/

// 初始化后,所有直接调用log包的日志输出都会受影响
func init() {
// 设置日志的前缀信息
log.SetPrefix("[LogPrefix] ")
// 设置日志的中段标示,参考上边的注释
log.SetFlags(log.Ldate | log.Lmicroseconds | log.Lshortfile)
}

上边的代码很简单(前提是忽略掉注释部分),在init函数中先初始化log的基本格式,就是在输出到屏幕时的样式。

调用更简单:

1
2
3
4
5
6
7
8
9
10
package main

import "log"

func main() {
log.Println("hello world")
}

// ------------以下是程序输出--------------
[LogPrefix] 2019/03/09 14:34:06.763601 main.go:6: hello world

init函数中,log被设置了前缀[LogPrefix] 以及中间部分的完整时间日志+文件名及行号,所以一个简单的helloworld日志信息前会自动追加很多有效调试信息。

这里只需要记住一点,log包一旦被设置,全局有效!

那么问题来了,如果我需要两种以上不同的日志格式怎么办?答——log.Logger。

先定义一套自己的Logger规则:

1
2
3
4
5
6
var (
Trace *log.Logger // 普通跟踪调试信息
Info *log.Logger // 特殊信息
Warning *log.Logger // 警告日志
Error *log.Logger // 错误日志(输出到文件)
)

如上,定义了4个logger对象,分别用于:

  • 普通信息:程序正式发布时,该部分不再输出
  • 特殊信息:总是打印到屏幕上
  • 警告:类似于“特殊信息”,你要愿意,也可以修改其字体颜色
  • 错误:同时将日志打印到屏幕,保存至文件

有了这4套机制的需求后,再来看看它们是如何被实现的:

1
2
3
4
5
6
7
8
9
10
11
12
13
func init() {
file, err := os.OpenFile("error.log", os.O_CREATE|os.O_WRONLY|os.O_APPEND, 0666)
if err != nil {
log.Fatalln("Failed to open error file: ", err)
}

// 因为ioutil.Discard,所有通过Trace打印的日志都不会输出
Trace = log.New(ioutil.Discard, "TRACE: ", log.Ldate|log.Ltime|log.Lshortfile)
Info = log.New(os.Stdout, "INFO: ", log.Ldate|log.Ltime|log.Lshortfile)
Warning = log.New(os.Stdout, "WARNING: ", log.Ldate|log.Ltime|log.Lshortfile)
// io.MultiWriter表示多种输出渠道,即同时打印到屏幕和文件
Error = log.New(io.MultiWriter(file, os.Stderr), "ERROR: ", log.Ldate|log.Ltime|log.Llongfile)
}

核心只有一个:log.New(out io.Writer, prefix string, flag int)函数,会根据参数设置好logger的输出目的地、前缀信息、日志标示等,并将其返回。

留意一下,Trace这个logger的输出对象是ioutil.Discard,其实就是不输出的意思;而另一处logger的对象Error关于io.MultiWriter()表示多目标输出,可以看到,既要输出到file,还要输出到stderr。

好了,至于这4个logger的调用方式嘛,和标准库中的log是一模一样的。

从Github上获取用户信息

为了学习调用GO的标准库进行json编解码,书中是用Google的API请求来举例……所以我觉得还是用GitHub来演示,效果会好一点。anyway anywhere,只要明白json序列化和反序列化即可。

反序列化

先用浏览器随便GET个用户信息试试,比如就我自己的地址:https://api.github.com/users/philon

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
{
"login": "Philon",
"id": 2968783,
"node_id": "MDQ6VXNlcjI5Njg3ODM=",
"avatar_url": "https://avatars0.githubusercontent.com/u/2968783?v=4",
"gravatar_id": "",
"url": "https://api.github.com/users/Philon",
...
"public_repos": 4,
"public_gists": 0,
"followers": 15,
"following": 0,
"created_at": "2012-12-05T06:28:25Z",
"updated_at": "2019-03-06T12:47:11Z"
}

多句嘴,我觉得GitHub的RESTful设计得相当不错!

可以看到GitHub返回了我的个人账户信息,并且是json格式,如果在GO程序中同样可以采用http.Get()函数获取到这些信息,只可惜get到的全部是一对字符串,如何将其变成一个便于处理和调用的数据结构呢?两种方式:

方式一、类型映射

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
// User Github用户账户信息
// 每个变量最后用反引号标示的字符串是——标签
// 标签可为之后的json.Decoder提供映射依据
type User struct {
Login string `json:"login"`
ID int64 `json:"id"`
AvatarURL string `json:"avatar_url"`
GravatarID string `json:"gravatar_id"`
URL string `json:"url"`
HTMLURL string `json:"html_url"`
FollowersURL string `json:"followers_url"`
FollowingURL string `json:"following_url"`
GistsURL string `json:"gists_url"`
StarredURL string `json:"starred_url"`
SubscriptionsURL string `json:"subscriptions_url"`
OrganizationsURL string `json:"organizations_url"`
ReposURL string `json:"repos_url"`
EventsURL string `json:"events_url"`
RecievedEventsURL string `json:"recieved_events_url"`
Type string `json:"type"`
SiteAdmin bool `json:"site_admin"`
Name string `json:"name"`
Company string `json:"company"`
Blog string `json:"blog"`
Location string `json:"location"`
Email string `json:"email"`
Hireable string `json:"hireable"`
Bio string `json:"bio"`
PublicRepos int32 `json:"public_repos"`
PublicGists int32 `json:"public_gists"`
Followers int32 `json:"followers"`
Following int32 `json:"following"`
CreateAt string `json:"create_at"`
UpdateAt string `json:"update_at"`
}

// DeserializeToType 获取用户信息,并反序列化为User类型
func DeserializeToType(name string) {
// 根据用户名从GitHub获取对应用户的json信息
resp, err := http.Get("https://api.github.com/users/" + name)
if err != nil {
log.Println("ERROR: ", err)
}

defer resp.Body.Close()

var user User
// 通过Decode将响应内容反序列化为对象
err = json.NewDecoder(resp.Body).Decode(&user)
if err != nil {
log.Println("ERROR: ", err)
}

fmt.Printf("user: %v\n", user)
}

以上的代码很长,但归根结底就两个部分:

  1. 在struct类型定义中,通过name type tag的标准格式定义结构类型中的每个属性,注意最后反引号框起来的标签,它用于之后给json反序列化提供映射依据——如果仔细比对就会发现,每个tag中的名称都和GitHub响应返回的json中的键名严格一致。
  2. DeserializeToType函数其实就是具体的反序列化过程了,只需要记住json.NewDecoder().Decode(&user)这个标准库中的函数即可,该函数会根据第1部分的tag将json数据解析后填入对象中。

方式二、字典映射

有的时候,其实没必要为每个json消息都定义类型,不然得累死,所以GO提供了一种更为灵活的方式——字典。还是以获取GitHub用户信息为例:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
func DeserializeToMap(name string) {
resp, err := http.Get("https://api.github.com/users/" + name)
if err != nil {
log.Fatalln("ERROR: ", err)
}

defer resp.Body.Close()

// 读取响应Body并转化为[]byte数据结构
content, err := ioutil.ReadAll(resp.Body)
if err != nil {
log.Fatalln("ERROR: ", err)
}

var user map[string]interface{}
// 通过Unmarshal将[]byte转换为字典
err = json.Unmarshal(content, &user)
if err != nil {
log.Fatalln("ERROR: ", err)
}

fmt.Println("Username: ", user["login"])
fmt.Println("Followers: ", user["followers"])
}

在上述代码中,先通过ioutil.ReadAll将服务器端的响应读取出来并转换为[]byte字节流形式,然后在通过json.Unmarshal把这个字节流转换成map[string]interface{}的数据字典形式,注意字典的类型必须是这种,不要随意更换。

如果要根据json中的键来获取值信息就非常简单了,就是上述代码的最后两行user["key"]即可。

序列化

明白了反序列化的处理方式,还要懂得序列化,毕竟请求/应答不分家,那么如何将一个具体的数据结构转化为json字符串呢?方式只有一种json.Marshal,但要注意数据类型一般是两种:对象和字典。

类型对象的序列化:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
func SerializeType() {
user := &User{
Login: "张三",
ID: 9527,
URL: "https://api.github.com/users/ZhangSan",
}

// 带缩进格式的序列化,缩进为4个空格
data, err := json.MarshalIndent(user, "", " ")
if err != nil {
log.Fatalln("ERROR: ", err)
}

fmt.Println(string(data))
}

上述代码定义了一个User对象,并通过json.MarshalIndent非常容易就将其转换为data字节流,为了输出我们把它强转为string类型。

留意一下,func MarshalIndent(v interface{}, prefix, indent string) 函数是带格式化的转换,也就是说,默认情况下,json字符串其实没有空格和换行的,这个函数可以根据你的喜好从新将其格式化。

字典的序列化:

1
2
3
4
5
6
7
8
9
10
11
12
13
func SerializeMap() {
c := make(map[string]interface{})
c["name"] = "张三"
c["id"] = 9527

// 不带缩进格式化的序列化
data, err := json.Marshal(c)
if err != nil {
log.Fatalln("ERROR: ", err)
}

fmt.Println(string(data))
}

字典无需过多重复,和反序列化那部分基本一样。

输入输出

关于io.Reader和io.Writer就我个人而言,没有太多值得牢记的地方,最多也就一句话:但凡实现io.Reader/Writer接口的类型,都可以被标准库中的io调用。

以书中的例子来说:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
func main() { 
// 创建一个Buffer值,并将一个字符串写入Buffer
// 使用实现io.Writer的Write方法
var b bytes.Buffer
b.Write([]byte("Hello "))

// 使用Fprintf来将一个字符串拼接到Buffer里
// 将bytes.Buffer的地址作为io.Writer类型值传入
fmt.Fprintf(&b, "World!")

// 将Buffer的内容输出到标准输出设备
// 将os.File值的地址作为io.Writer类型值传入
b.WriteTo(os.Stdout)
}

上述代码中,首先Buffer类型实现了Write方法,所以变量b可以被标准的fmt.Fprintf接受。而Buffer.WriteTo(*File)函数是写到一个文件中,os.Stdout就是标准输出文件。

Reader.Read()接口几乎也是同样的道理,只要实现Read接口的类型,都可以被标准库接受。

我觉得书中本章最开始的话也充分反映了GO语言的思想:GO开发者会比其它语言的开发者更依赖标准库里的包。为什么要非常熟悉GO语言的标准库,为什么要充分掌握其接口的实现原则。从上边的三个例子中就可以看出,每当我们需要增加新业务时,完全可以仅实现标准库中的某个接口,就可以近乎完美地衔接进整个GO生态。

比如我为某个结构类型实现了Writer.Write()接口,我几乎可以肯定,这个类型同时“继承”了log、json包里的诸多功能。

小结一下

  • 标准库有特殊的保证,并且被社区广泛应用。
  • 使用标准库的包会让代码易于管理,更加受信任。
  • 标准库放在$GOROOT/pkg下,以静态库形式存放。
  • log.Logger可以定制自己的日志形式。
  • json包可以通过结构类型的标签,实现序列化和反序列化
  • map[string]interface{}也可以用于json编解码
  • 接口允许代码组合已有的功能,得接口者得全标准库
  • 熟悉标准库!熟悉标准库!熟悉标准库!
0%