自增人生

何以解忧,唯有 i++

Don’t Touch that Code!

在我们每个人身上都发生过。你的代码放到预演服务器上用于系统测试,然后测试经理反馈她发现了个问题。你的第一反应就是“快,让我修复它——我知道错误在哪儿。”

从更大的意义上来说,尽管,作为一个开发者犯的错,你觉得你应该去访问预演服务器。

大多数基于web的开发环境中,架构可以像这样分解:

  • 本地开发,并在开发者机器上完成单元测试
  • 手动或自动完成在开发服务器上集成测试
  • QA团队和用户访问预演服务器完成测试
  • (发布到)生产服务器

是的,那里还有其它的服务器和服务,就像源码控制和票据,但你获得了注意。使用这个模型,一个程序员——甚至是一个有资历的程序员——应该永远不要访问除了开发服务器意外的东西。很多开发是在开发者本地机器用他们喜欢的IDE、虚拟机上完成的,为了好运,还会撒上适量的黑魔法。

一旦进入SCC检查,不论是自动还是手动,都应该将其从开发服务器转交出去,并可以在其它地方被测试和调整,以确保一切工作正常。尽管,从这点来看,开发者在此过程中只能是一个观众。

预演经理应该为QA团队打包并转移代码到预演服务器。就像开发者不需要访问任何开发服务器意外的事情一样,QA团队和用户也要碰任何在开发服务器上的东西。如果它准备接受测试,切出发布(分支)并移交,不要再让用户到开发服务器上“只是看一点东西,真的很快”。记住,除非整个工程代码都是你写的,否则其他人会在上面改代码,并且他们可能并没有准备好让用户看。发布经理才是唯一应该访问这两者的人。

在任何,所有情况下——都不应该——让一个开发人员去访问生产服务器。如果又问题,你的技术支持人员要么修复它,要么请求修复它。在SCC检入之后,它们将在此滚动一个补丁。我曾目睹过一些超大型的编程灾难发生,由于某些人(咳咳)违反了这条规则。如果它破掉了,生产可不是修复它的地方。

我大概是在某个播客节目中听到本书的名字,同时因为对文革、网络喷子、游行示威、打砸等历史或现象多少有些兴趣,便怀着好奇心翻开了这本书。从《乌合之众:大众心理研究》的书名都能猜到,这本书就是讲群众行为和心理的,不论题材和角度都能,或多或少有些发人深省的地方。所以,想要对某些群体心理多些洞察力,这本书还是值得一读的。

但是,从文体内容而言,我感觉这本书就想一本心理学论文,不乏很多枯燥的长篇论述,食之无味。如果我是一名心理学家或者社会学家,那这本书也许能持续挑逗我的精神味蕾,可偏偏我就是个门外汉,那些长篇大论除了帮助我增加丝丝睡意外,好像也没什么能吸引我的地方。

阅读全文 »

我们可以通过goroutine和channel机制非常方便地编写并发业务,但就和面向对象与设计模式的关系一样,是一种思想具体落实到行动方针的过程,在牛逼的战略,没有基本的战术指导,也只是空谈。

因此,第七章并发模式,并没有太多语法上的新东西,而是利用goroutine和channel介绍了三种并发模式,分别适用于三种不同的业务场景。

  1. runner——给每个并发任务设置deadline,管理并发任务的生命周期
  2. pool——利用有缓冲通道创建资源池,统一管理并发时的资源访问
  3. work——利用无缓冲通道创建goroutine池,统一管理并发

runner

先假设一个场景需求,比如http服务的并发,我们要为每个来自客户端的请求创建一个临时的并发响应任务,但这个最好在某个规定的时间内完成响应,否则就强制它退出,这样可以很好地避免某些情况下,一些并发任务卡死的情况,同时可以很好地管理每个并发的生命周期。

runner就是为这样的场景应用而生的,runner可以理解为是一个运行管理器,所有的并发任务都要叫给它负责管理,它负责并发任务的启动、超时监控、强制中断等。

(由于我个人在阅读原著的时候是先讲runner的内部实现,再看实际应用,总感觉云里雾里的,觉得还是先通篇看一下如何运用runner,再来看其内部的实现,可能效果会好一点)

先来看runner的示例:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
func testRunner() {
log.Println("Runner test starting work...")

// 新建一个runner,并强制每个并发任务的超时时间为5秒
r := runner.New(3 * time.Second)
// 循环创建10个并发任务,并将其丢给runner管理
for i := 0; i < 5; i++ {
r.Add(func(id int) {
// 这里只是模拟,每个并发任务都是睡眠它自身id的秒数
log.Printf("Processor - Task #%d.\n", id)
time.Sleep(time.Duration(id) * time.Second)
log.Printf("Task #%d done.\n", id)
})
}

// 一次性启动runner内部的全部并发任务
if err := r.Start(); err != nil {
switch err {
case runner.ErrTimeout:
// 当并发任务中有任务执行超时,就立即返回
log.Println("Terminating due to timeout.")
os.Exit(1)
case runner.ErrInterrupt:
// 当程序被ctrl+c时,强制结束所有并发任务
log.Println("Terminating due to interrupt.")
os.Exit(2)
}
}

log.Println("Process end.")
}

//-------------程序输出---------------
2019/03/03 14:48:41 Runner test starting work...
2019/03/03 14:48:41 Processor - Task #2.
2019/03/03 14:48:41 Processor - Task #4.
2019/03/03 14:48:41 Processor - Task #3.
2019/03/03 14:48:41 Processor - Task #0.
2019/03/03 14:48:41 Task #0 done.
2019/03/03 14:48:41 Processor - Task #1.
2019/03/03 14:48:42 Task #1 done.
2019/03/03 14:48:43 Task #2 done.
// ----第3个及以后的任务因为要睡3秒以上,肯定会超时----
2019/03/03 14:48:44 Terminating due to timeout.
// ----如何运行过程中按ctrl+c,会安全退出并提示----
^C2019/03/03 14:49:36 Terminating due to interrupt.

可以看到,runner就是一个类型,需要用其创建对象后才能具体使用。而在外部,我们只需要定义好每个任务的函数,并简单的将它们添加到runner当中即可,剩下的全部交由runner自行管理。

现在再来看看runner类型是如何实现的:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
// Runner 在指定的超时时间内完成一组任务
// 并且在这个时间周期内接收系统的中断信号来结束这组任务
type Runner struct {
// 从系统接收中断信号的通道
interrupt chan os.Signal
// 任务已完成的报告通道
complete chan error
// 任务超时的报告通道
timeout <-chan time.Time
// 任务列表
tasks []func(id int)
}

// ErrTimeout 任务执行超时时返回
var ErrTimeout = errors.New("received timeout")

// ErrInterrupt 收到系统中断信号时返回
var ErrInterrupt = errors.New("received interrupt")

// New 创建Runner的工厂函数
func New(d time.Duration) *Runner {
return &Runner{
interrupt: make(chan os.Signal, 1),
complete: make(chan error),
timeout: time.After(d),
}
}

// Add Runner的方法,将多个任务添加到Runner的任务列表中
func (r *Runner) Add(tasks ...func(int)) {
r.tasks = append(r.tasks, tasks...)
}

// Start Runner的方法,启动所有任务,并监听通道事件
func (r *Runner) Start() error {
// 开始接收系统的中断通知
signal.Notify(r.interrupt, os.Interrupt)

// 通过gorouting并行启动所有任务列表中的任务
var wg sync.WaitGroup
wg.Add(len(r.tasks))
for i, t := range r.tasks {
go func(id int, task func(int)) {
task(id)
wg.Done()
}(i, t)
}
// 等待所有任务执行完成,并给“已完成通道”一个报告
go func() {
wg.Wait()
r.complete <- nil
}()

// 获取无缓冲通道数据时,如果没准备好,会被阻塞
select {
case err := <-r.complete: // 任务正常实行完返回任务自身的“错误标示”
return err
case <-r.timeout: // 任务执行超时,返回超时错误
return ErrTimeout
case <-r.interrupt: // 如果收到ctrl+C则停止接收后续的信号
signal.Stop(r.interrupt)
return ErrInterrupt
}
}

由于只是原型演示,runner的内部实现不算复杂,只需要记住一个核心思想无缓冲通道在没有数据读写的时候,会被阻塞。说千道万,runner就是利用了这个特性才得以在select语句中完成了:

  • 并行接收系统的中断信号——interrupt通道。
  • 并行接收定时器的超时信号——timeout通道。

pool

这里的pool是指资源池的意思,如果熟悉Java/C#中的“数据连接池”的概念,那这里的池大体就是这个意思了。

换而言之,在并发场景下,难免会遇到并发任务争夺临界资源的情况,还是以数据库访问为例:如果有1000个并发任务要去访问数据库,每个并发都需要完成建立连接——认证——查询——断开连接等操作,那不论是应用服务器还是数据库服务器,无疑都是巨大的负担。因此,通过创建10个数据库连接,并把这些“连接”当作资源放入“池”中,给所有的并发任务共享,每个并发在需要的时候从池中取出连接,完成查询后再放回池中,不仅能大幅降低CPU的负载,也能减少内存的开销。(但我个人觉得最爽的地方是,你的代码可以更专注地去query,而不必考虑connection本身😂)

同样,先来看看pool的运用过程:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
const (
maxGoroutines = 25 // 要使用的goroutine的数量
pooledResource = 5 // 池中的资源的数量
)

// dbConnection 模拟要共享的资源
type dbConnection struct {
ID int32
}

// Close 实现io.Closer.Close接口,释放资源
// 让其可以被Pool管理
func (dbConn *dbConnection) Close() error {
log.Println("Close: Connection", dbConn.ID)
return nil
}

// idCounter 用来给每个连接分配唯一id
var idCounter int32

// createConnection 创建唯一id的连接
func createConnection() (io.Closer, error) {
id := atomic.AddInt32(&idCounter, 1)
log.Println("Create: New Connection", id)

return &dbConnection{id}, nil
}

// testPool Pool测试用例
func testPool() {
var wg sync.WaitGroup
wg.Add(maxGoroutines)

// 创建管理连接池,并创建N个“连接”资源,加入池中
p, err := pool.New(createConnection, pooledResource)
if err != nil {
log.Println(err)
}

// 创建M个并发任务,模拟查询数据库
for query := 0; query < maxGoroutines; query++ {
go func(q int) {
performQueries(q, p)
wg.Done()
}(query)
}

wg.Wait()
log.Println("Shutdown Program")
p.Close() // 关闭池
}

func performQueries(query int, p *pool.Pool) {
conn, err := p.Acquire()
if err != nil {
log.Println(err)
return
}

// 完成查询后,将资源释放会池里
defer p.Release(conn)

// 用随机睡眠1000微妙内的时长,来模拟查询中的耗时
time.Sleep(time.Duration(rand.Intn(1000)) * time.Millisecond)
log.Printf("QID[%d] CID[%d]\n", query, conn.(*dbConnection).ID)
}

(可能是我没学习到位,我个人觉得pool模式并不是特别容易掌握,思想是很好理解的,但牵扯太多接口实现、有/无缓冲通道的特性等内容,所以代码可能要再多消化几遍。)

再看看pool包的实现:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
// Pool 资源池
// 管理一组资源,可以安全地在多个goroutine共享
// 实现 io.Closer接口
type Pool struct {
m sync.Mutex
resource chan io.Closer
factory func() (io.Closer, error)
closed bool
}

// ErrPoolClosed 资源池已关闭的错误标示
var ErrPoolClosed = errors.New("Pool has been closed")

// New 创建Pool的工厂函数
func New(fn func() (io.Closer, error), size uint) (*Pool, error) {
if size <= 0 {
return nil, errors.New("size value too small")
}

return &Pool{
factory: fn,
resource: make(chan io.Closer, size),
}, nil
}

// Acquire 从资源池中获取一个资源
func (p *Pool) Acquire() (io.Closer, error) {
select {
case r, ok := <-p.resource:
// 检查是否有空闲资源
log.Println("Acquire:", "Shared Resource")
if !ok {
return nil, ErrPoolClosed
}
return r, nil
default:
// 如果没有可用资源,就创建一个
log.Println("Acquire:", "New Resource")
return p.factory()
}
}

// Release 释放一个资源,将其放回资源池
func (p *Pool) Release(r io.Closer) {
p.m.Lock()
defer p.m.Unlock()

// 如果该资源已经被关闭,销毁这个资源
if p.closed {
r.Close()
return
}

select {
case p.resource <- r:
// 试图将该资源加入队列
log.Println("Release:", "In Queue")
default:
// 如果队列已满,关闭这个资源
log.Println("Release:", "Closing")
r.Close()
}
}

// Close 关闭资源池中的所有资源,并停止工作
func (p *Pool) Close() {
p.m.Lock()
defer p.m.Unlock()

if p.closed {
return
}

p.closed = true

close(p.resource)

// 关闭所有资源
for r := range p.resource {
r.Close()
}
}

pool资源池实现的核心思想是有缓冲通道读写时不会引起阻塞,select语句在通道内没有数据的情况下会自动执行default选项。

work

work模式就是创建一个goroutine池,管理池中所有的goroutine统一执行。但它有别于runner模式,runner其实是负责监控池中的每个并发任务的生命周期的,而work则是负责池中的每个并发任务的执行顺序,即任务队列。

这个模式的好处在于,可以很好地控制程序运行的负载,比如突发情况下,某台服务器的http请求一瞬间到达100万,如果为了响应所有请求也在一瞬起启动100万个响应任务,那估计服务器就冒烟了。所以最好的方式就是限制并发任务数量,比如每次最多启动1万个响应,剩下的排队慢慢来。

因此,work就是一个并发任务的队列池,还是先看看如何运用的:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
var names = []string{
"steve",
"bob",
"mary",
"therese",
"jason",
}

type namePrinter struct {
name string
}

// Task 实现Worker接口
func (m *namePrinter) Task() {
log.Println(m.name)
time.Sleep(time.Second)
}

func testWork() {
// 设置工作池的“工位”为2,即每次只能有两个人工作
p := work.New(2)

var wg sync.WaitGroup
wg.Add(100 * len(names)) // 每人肩负100项任务,共5人

// 一次性把5 * 100个任务全部丢到工作池中
// 相当于创建了500个goroutine
for i := 0; i < 100; i++ {
for _, name := range names {
np := namePrinter{name: name}
go func() {
p.Run(&np) // 将对象的任务丢到工作池中统一管理执行
wg.Done()
}()
}
}

// 等待所有任务在工作池中被完成
wg.Wait()
p.Shutdown()
}

如上代码,namePrinter实现了work包内规定的Task接口之后,work的工作池就能够统一管理namePrinter对象了。这个namePrinter可以理解为某个业务的模拟,比如上面说的http响应任务(这里仅是简单地做个打印)。

而后,不论创建多少个namePrinter相关的goroutine(并发),都只需简单地将其丢到工作池中Run(p.Run并没有立刻启动任务,工作池会根据情况自行安排)。

最后在看看work包的实现:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
// Worker 必须满足接口,才能使用工作池
type Worker interface {
Task()
}

// Pool 工作池,相当于goroutines池管理
type Pool struct {
work chan Worker
wg sync.WaitGroup
}

// New 创建工作池的工厂函数
func New(maxGoroutines int) *Pool {
p := Pool{
work: make(chan Worker),
}

p.wg.Add(maxGoroutines)
for i := 0; i < maxGoroutines; i++ {
go func() {
// p.work是通道,所有创建goroutine之后
// for循环会被阻塞,直到p.work被关闭为止
for w := range p.work {
w.Task()
}
p.wg.Done()
}()
}

return &p
}

// Run 提交工作到工作池
func (p *Pool) Run(w Worker) {
p.work <- w
}

// Shutdown 等待所有goroutines结束
func (p *Pool) Shutdown() {
close(p.work)
p.wg.Wait()
}

work的实现其实是非常简单的,核心思想是for-range循环时,无缓冲通道会阻塞,工作池是一个无缓冲通道,而每个for-range都相当于一个队列,当池中有数据是,所有的for-range都会争夺这个输入数据来处理,但如果某个队列本身已经在工作时,就没空再争夺通道内的数据。可以说是最简单有效的负载均衡。

小结一下

  • 无缓冲通道在读写时会引起阻塞,可以用来控制程序生命周期
  • 带default分支的select语句会尝试读写通道,而不会阻塞
  • 可以利用无缓冲通道创建一个工作池,统一管理goroutine并发任务
  • 可以利用有缓冲通道创建一个资源池,统一管理并发时的资源访问

Don’t Repeat Yourself

编程的所有原则中,不要重复自我(DRY)或许是最基本的原则之一。该原则被Andy Hunt和Dave Thomas的《程序员修炼之道》一书中提出,便成了很多为知名软件开发的最佳实践和设计模式的基础。开发人员学习辨认副本,并理解如何通过适当的实践和抽象来消除这些重复,相比于一直被传染多余的重复代码的应用程序,可以产出更简洁的代码。

复制是种浪费

应用程序的代码中的每行代码都将会维护,也将会成为潜在的bug。重复会使代码库不必要的臃肿,结果让bug有机可乘,并增加系统的耦合度。重复的臃肿加入系统也会让开发者难以彻底理解系统全貌而,还有一点可以确定,另外为了确保它们能正常工作,修改了某处的逻辑也需要修改另一处的复制。DRY需要“系统内每处的知识都必须具有单一、明确、权威的表示”。

过程中的重复要自动化

很多软件开发中的流程都是简单而重复的自动化。DRY原则适用于这些应用程序源码中的上下文。手动测试太慢了,容易出错,也很难重复操作,所以如果可能的话,自动化测试套件应该被用起来。如果手动进行软件集成可能会耗时且容易出错,因此构建过程应尽可能频繁地运行,理想情况下每次签入(代码库)时都跑一遍。只要存在能被自动化的痛苦的人工流程,都应该被自动化和标准化。其目标是确保仅有唯一的方式来完成任务,并且要尽可能做到无痛。

逻辑中的重复要抽象

逻辑中的重复会有很多形式。复制粘贴if-then或switch-case逻辑是最容易检查并纠正的。很多设计模式都有明确的目标,要降低或消除应用程序中的重复。如果一个对象在使用前需要同时具备几个事情的发生,就可以用抽象工厂或者工厂方法来完成。如果一个对象的行为会有很多可能的变化,这些行为就可以通过策略模式来注入,要好于大量的if-then结构。事实上,设计模式本身的制定是为了降低常见问题带来的重复,并讨论这些解决方案。此外,DRY可以适用于数据结构,如数据库模式,从而更规范。

一个原则问题

其它的软件原则也和DRY相关。有且仅有一次原则,仅适用于代码功能行为,可以被认为是DRY的一个子集。开闭原则,“软件中的实体应对扩展开放,对修改封闭”的情况,仅在遵循DRY时才能在实践中起作用。同样众所周知的单一职责原则,需要一个类“只有一个改变原因”依赖于DRY。

当遵循结构、逻辑、流程、以及函数时,DRY原则能为开发人员提供基本指导,并帮助创建更简单,更易于维护,更高质量的应用。尽管有一些情况下,必须用重复来满足性能或其它需求(例如数据库中的非规范化数据),它应该被直接用于解决实际而非想象的问题。

Don’t Rely on “Magic Happens Here”

如果你看过足够多的任何活动、流程、或纪律,它们都看起来很简单。一个没有开发经验的经理会认为程序员做的事情很简单,同样的,一个没有管理经验的程序员也会这么看待经理所做的事情。

编程是一些人在一些时候做的事情。其中困难的部分——思考——是最不容易被外行看到和赞赏的。几十年来,已经有许多尝试想要移除这些熟练思维的需求。最近的也是最难忘的一个是格蕾丝·赫柏(Grace Hopper)致力于使编程语言不那么神秘——一些人语言这将消除对专业程序员的需求。结果(COBOL语言)在随后的几十年中为大量的专业程序员的收入作出了贡献。

消除编程以简化软件开发是个长久的愿景,对于熟知其(内部的)复杂程序的程序员而言,显然很天真。但是导致这些错误的心理过程是人性的一部分,程序员也会想他人一样容易出现。

在任何项目中,有很多潜在的事情是个别程序员没有积极参与的:从用户中引出需求,获得预算审批,设置构建服务器,部署应用到质量保证和生产环境,从旧的流程或程序中迁移业务,等等。

当你无法积极参与到某件事中时,就会无意识地趋于假设它们都很简单或着会有“魔法”出现。尽管魔法持续出现让一切安稳。但是——它们通常是“何时”而不是“如果”——魔法的停止了,该项目就会陷入困境。

我知道项目于会消耗掉数周开发者的时间,因为没有一个人了解该怎样加载它们依赖的“正确”版本的dll。当事情开始断断续续地出错时,在有人注意到正在加载“一个错误”版本的dll之前,团队成员还在任何地方查找。

其它部门运转平稳——项目准时交付,没有推迟夜间调试会议,没有紧急修复。如此平稳,事实上,高级经理都觉得这事能“自己运转”,它们都不需要管理者了。然而6个月内,该部门的项目看起来就像组织的多余部分一样——太迟了,疯狂连续的打补丁。

你不需要理解所有的让你项目工作的魔法,但理解它的一部分也没坏处——或者感激那些懂得你未知领域的人。

最重要的是,确保当魔法停止的时候,它可能再次启动。

首先要肯定,这本书的阅读体验非常好,本书总结了52种生活“常见”的思维误区,每一种都是一千字左右的总结,其内容浅显易懂但又略带颠覆,加上一些配图,读起来干净利落。

不过阅读归阅读,这种观点“零散”的内容不利于写书评,我也不打算给每种思维错误都写个总结——毕竟就一千多字,还不如读原文。所以我只是简单地穿插其中的一些我认为比较重要的观点,整理成文。

阅读全文 »

但凡复杂一点的业务,并发基本跑不了,其实说白了无非是多线程/多进程架构,可一旦涉及并发模式,少不了调度、同步、互斥、资源访问等一堆堆问题,解决这些问题又需要一堆堆代码,这些代码不仅维护难度高,而且可以说和业务本身没有半毛钱关系(纯粹的技术问题有木有)。

But!GO语言对并发的运用相比其它语言还是相当愉快的。根据本章内容可以学到,GO语言的“多线程”机制goroutine,以及多线程之间的通信方式channel。

GO运行时(runtime)

在说GO的并发之前需要先搞清楚一件事,否则后面会一头雾水。

由于前几章并没有特别说明,加上go build命令可以直接生成一个独立的可执行文件(而且没有任何依赖),会让人误以为go程序是类似c/c++一样的机器码。其实不然,GO的可执行文件内部嵌入了runtime,本质上和Java/.Net一样跑在虚拟机之上。

GO的运行时负责内存管理、垃圾回收、栈处理等等,而其中一个很重要的功能便是goroutine和channel的管理。

通常情况下,GO运行时默认给整个应用程序分配一个逻辑处理器,逻辑处理器会绑定到物理处理器上。一个GO程序默认最多创建10000个线程,但可以通过runtime包的SetMaxThreads方法来修改,程序里的线程超出最大线程数会导致程序崩溃。

goroutine

所以通过上述要搞懂,goroutine不是系统分配的线程,更不归操作系统调度,一切都是靠运行时分配和调度。但不论如何,为了便于前期的学习和理解并发,这里默认goroutine就是线程。

先来创建10个线程:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
func main() {
var wg sync.WaitGroup
wg.Add(10) // WaitGroup计数加10

for i := 0; i < 10; i++ {
// 创建goroutine
go func(id int) {
fmt.Printf("Goroutine-%d\n", id)
wg.Done() // WaitGroup计数减1
}(i)
}

wg.Wait() // 等待,直到WaitGroup计数为0
}

代码输出:

1
2
3
4
5
6
7
8
9
10
Goroutine-2
Goroutine-9
Goroutine-1
Goroutine-3
Goroutine-5
Goroutine-8
Goroutine-4
Goroutine-7
Goroutine-6
Goroutine-0

从上面代码可以看出,for循环只是顺序创建了10个goroutine,但输出是并行的,没有顺序。

再强调一遍,goroutine不是线程

尽管从效果上看,goroutine就是线程,但事实是上边的程序只有一个线程,交由go运行时维护,线程内部会自动负责多个goroutine的调度管理。

并发竞争

有并发的地方,就有资源竞争。只需要把上边的代码稍作改动:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
var count int // 声明一个全局变量

func main() {
var wg sync.WaitGroup
wg.Add(5)

for i := 0; i < 5; i++ {
go func() {
defer wg.Done() // 👈匿名函数退出时调用

var num = count // 读全局变量
fmt.Printf("num = %d\n", num)
count = num + 1 // 写全局变量
}()
}

wg.Wait()
// 所有goroutine结束后,count值并不为5
fmt.Printf("count = %d\n", count)
}
// ----------程序输出结果(每次都是随机的)--------
num = 0
num = 1
num = 0
num = 0
num = 0
count = 1

上述这段代码可以非常明显的看到,5个goroutine都对全局变量count做了加1的运算,结果count最终值却是1而非5。这也说明,在没有措施的情况下并发去访问全局变量会出现诡异的结果。

道理很简单,一个goroutine再访问某个资源时另一个goroutine可能正在写,导致访问结果不符合预期,或者你前脚刚写,后脚就被他人覆盖了。要解决这个问题,GO语言提供了两种传统思路:

  1. 原子操作函数,确保每次访问都是完整的读写
1
2
3
// atomic包里还有很多如读取、写入等安全访问函数
// 这里仅使用加法计算
atomic.AddInt64(&count, 1)
  1. 互斥锁,我在访问的时候你不准访问
1
2
3
4
var mutex sync.Mutex // 用来定义代码临界区
mutex.Lock() // 加锁,其它goroutine会被阻塞
...
mutex.Unlock() // 解锁,其它goroutine继续运行

通道

原子函数和互斥锁都可以很好地解决资源共享的问题,但它们都不够优秀,因为你不得不考虑程序的运行逻辑、优先级之类的问题。仔细想想,其实我们访问共享资源无非是为了生产/消费数据,只是为了确保数据能被安全访问才引入这样那样的竞争机制。那有没有一种办法能让开发者专注处理数据,不要去操心那些毫不相关的业务逻辑。答案就是GO的通道机制。

简单来说,一个goroutine需要读数据的时候,就从通道里去拿,处理完了就放回通道,至于那些资源互斥等问题,运行时已经处理得很完美了。

通道的基本使用

  • 用make和close来创建和关闭通道
  • 通道一般运行在goroutine函数内
  • 使用<-完成通道数据的读写
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
var wg sync.WaitGroup

// 接收端goroutine
func receive(data chan int) {
num := <-data // 将通道数据读取到变量
fmt.Printf("received number: %d\n", num)
wg.Done()
}

// 发送端goroutine
func send(data chan int, num int) {
fmt.Printf("sent number: %d\n", num)
data <- num // 将数据写入通道
wg.Done()
}

// UseChannel 通道的基本使用
func UseChannel() {
channel := make(chan int) // 创建一个通道
wg.Add(2)
go receive(channel)
go send(channel, 20)
wg.Wait()
close(channel) // 关闭通道
}

如上代码所示,通过channel := make(chan int)创建了一个int类型的通道,且通过该通道实现在recevie和send两个goroutine之间的数据通信,注意channel <- value表示写通道,value <- channel表示读通道。

另外,GO提供两种通道机制,无缓冲通道和有缓冲通道。

无缓冲通道

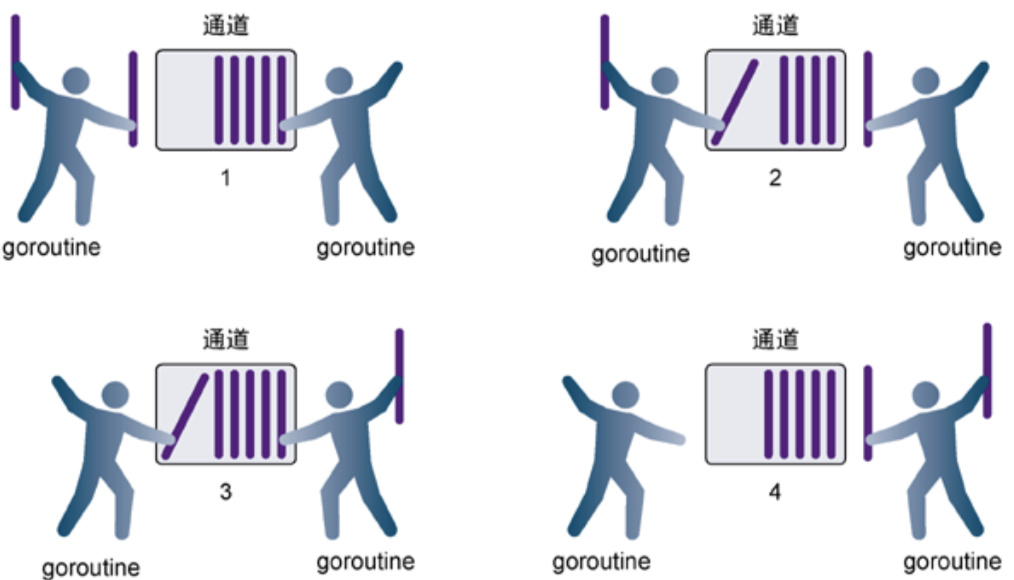
顾名思义,无缓冲就是在通道内不没有缓冲空间,对于两个goroutine而言,需要双方同时做好准备才能进行数据传递,否则先做好准备的一方就会阻塞,等待另一方做好准备。如下图所示:

无缓冲通道示意图

其实最开始关于send和recevie的例子就是典型的无缓冲通道,所以具体的用法就不再赘述了。

留意一下两个函数中fmt.Printf的顺序,发送者是在发送数据之前打印,而接受者是在接收数据之后打印。不过,两个函数是goroutine,理论上来说独自运行,打印没有先后次序,但上边的例子不论运行多少次都是先打印”sent number: xx"再打印”received number: xx"。由此可见,因为没有缓冲,num := <-data的时候,如果data通道的对面没有在写入,这里就会被阻塞。

有缓冲通道

同理,有缓冲就是在通道内有缓冲空间,对于两个goroutine而言,无所谓对方有没有做好准备,它们只需要关系通道内的缓存有没有数据,如下图所示:

有缓冲通道示意图

下面这段代码也展示了如果运用有缓冲通道,其实非常简单,就是在创建通道的时候指定一下通道的缓存长度make(chan <type>, <length>)即可,其它地方几乎不用变。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
func BufferChannel() {
// 创建一个长度为10的有缓冲通道
bufferedChannel := make(chan int, 10)
wg.Add(10)

// 启动5个goroutine接收数字
for i := 0; i < 5; i++ {
go receive(bufferedChannel)
}
// 启动5个goroutine发送随机5个数字
for i := 0; i < 5; i++ {
go send(bufferedChannel, rand.Intn(100))
}

wg.Wait()
close(bufferedChannel)
}

//---------------程序输出结果------------
sent number: 81
received number: 81
sent number: 81
sent number: 87
sent number: 47
received number: 81
received number: 87
received number: 47
sent number: 59
received number: 59
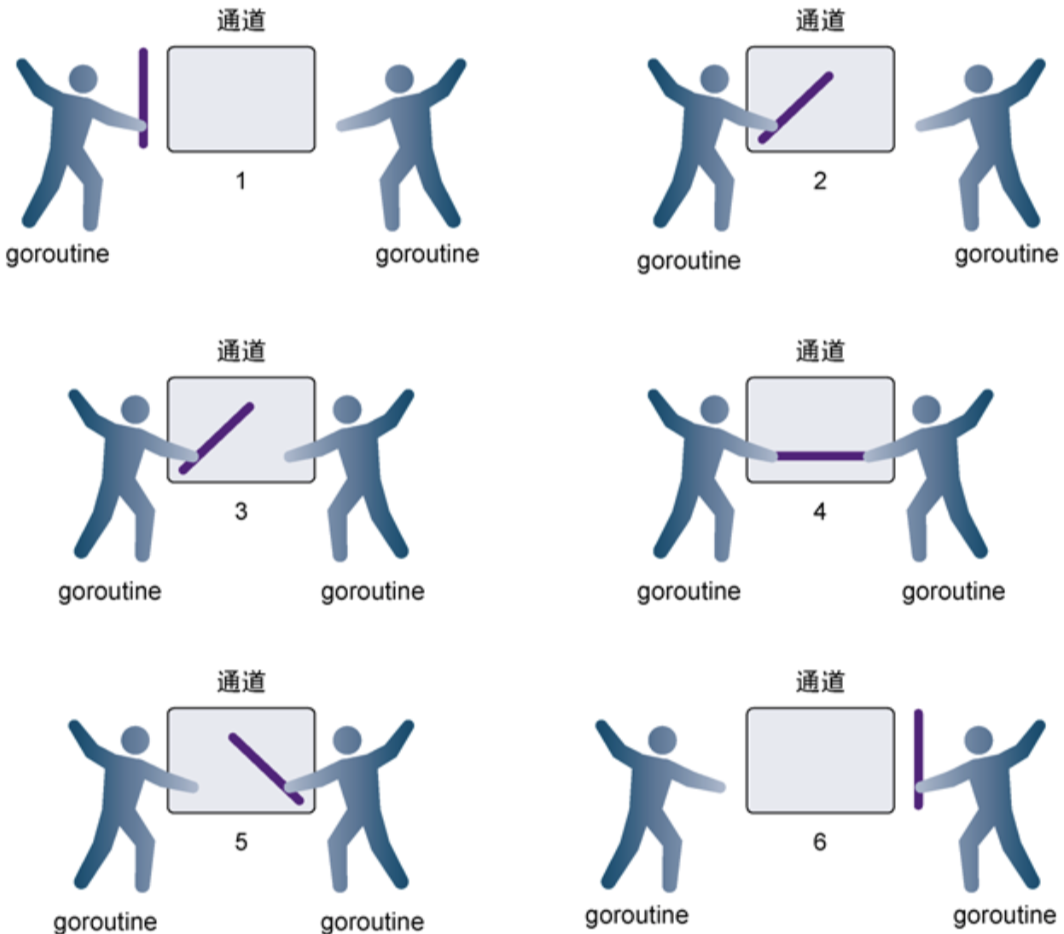
从这样的程序输出结果可以明显看到,receive和send的执行根本互不影响,不存在阻塞的情况,否则就不会出现连续发送和连续接收的打印了。

但是需要注意一点,发送数字和接收数字的顺序确实一样的,也就是说有缓冲通道内部,数据是按照先进先出的方式在管理。

小结一下

  • GO语言并发是指goroutine,由GO的运行时负责管理
  • 使用go关键字来创建goroutine
  • sync/atomic和sync.Mutex可以解决并发时的资源竞争问题
  • 相比于原子函数和互斥锁,GO语言的通道机制可以更好地处理共享数据
  • 使用make(chan <type>)创建无缓冲通道
  • 使用make(chan <type>, <length>)创建有缓冲通道

Don’t Nail Your Program into the Upright Position

我有次写了一个C++恶搞比赛,我讽刺地建议了以下的异常处理策略:

凭借遍布我们整个代码库的try...catch的结构,我们有时能够阻止程序的终止。我们把这种状态认为是“直立钉尸”。

尽管我的草率,实际上我还是总结了从这位祥林嫂(Dame Bitter Experience——或者叫艰苦岁月女?🥵)膝上学到的一课。

这是我们自制的C++库,是应用程序的一个基类。多年以后它被千“猿”所指:没有谁的手是干净的。它包含的代码把任何事情的异常都做了避开处理。通过Yossarian的第22条军规(Catch-22)作为指导,我们决定,或者说倾向于这个类的一个实例要么总是活着,要么赶紧死掉。(决定暗示更多想法,而不仅仅是进入这只怪物的结构)

为此,我们把多个异常交织在一起处理。我们把Windows的结构化异常与原生的类型混合在一起处理(记住C++中的__try..__except?我都没有)。当有意外抛出时,我们尝试再次调用,更难压入参数。回头看,我喜欢把一个try...catch处理写到另一个catch语句中,鬼使神差的让我可能从原本良好做法的高速公路走到了一条支路,进入一条芳香四溢但很不健康的疯狂车道。然而,这很可能是事后诸葛亮。

不用说,程序无论何时出错了,基本都是因为这个类,它们的消失就像是在码头的黑手党遇害者,只留下没用的气泡,鬼才知道发生了什么,尽管据说转储例程会记录这场灾难。最终——很长的最终——我们盘点了所做的事情,并因此感到羞愧。我们用一个小巧且健壮的报告机制替换了这个肮脏的家伙。但这是十分让人崩溃的。

我不会打扰你——去确认还有谁会向我们一样蠢——但我最近在线上和一个家伙讨论问题,他的学术职称表明他应该很牛逼。我们一起讨论了Java代码关于远程传输。如果代码失败了,他认为,应该在原地捕获并阻止异常。(“接下来做什么?” 我问。“拿去做夜宵么?”)

他引用了UI设计师的法则:永远不要让用户看到异常报告(大写),看似好像解决了问题,但这些大写的和任何内容又是什么。我想知道他是否会对这段代码负责:就是大量ATM机中的一台蓝屏了的照片,并造成了永久性创伤。无论如何,如果你见到了他,点头、微笑、不用声张,就像你走向这道门一样。

我在很多书里看到对道金斯这本《自私的基因》的引用,感觉应该是一本奇书,最近终于有幸拜读一番,果然很精彩。正如道金斯自己所说,希望作者把它当作一本科幻小说来阅读,其内容涵盖哺乳动物、鸟类、昆虫等诸多“有趣”的行为或现象,以及大量的形象比喻,关于生命的生存与繁衍背后的“道理”讲得非常浅显易懂。

阅读全文 »

类型——比“类”多了一个字而已,如果懂面向对象的话,类型的很多内容其实和面向对象语言如出一辙,但不同于面向对象思想。换而言之,Java/C#等常见的类的属性、方法、接口、继承等等形式,在GO的类型系统里都能找到身影,但其实现过程和思路却截然不同。

为了巩固本章的知识点,我仿照传统的MVC架构来实现一个“账户管理”的业务,作为GO与Java在实现面向对象方面的思想类比。在源码的account包中包含:

  • user——用户类型,基础模型
  • admin——管理员类型,“继承”于user
  • show——视图,用户信息打印,用接口实现user和admin多态
  • manage——服务,负责用户的增删改查

类型的定义

在GO语言中定义一个类是非常简单的:type user struct {},当然,它不叫类,而是结构类型,很像C语言中的结构体。

在user.go里声明了两个类型:Password和User,高手一看便知Password其实就是内置的string类型,感觉两者是可以互换的。然而一旦做了这样的声明之后,GO的编译器就会吧Password和string严格当作两种独立的类型来处理。换句话说,不能把string定义的变量直接赋值给Password类型的对象,只能在初始化时接收纯字符串。

1
2
3
4
5
6
7
type Password string

type User struct {
ID int // 包外可见
Name string // 包外可见
password Password // 包内可见
}

此外,需要注意GO语言的符号可见性。以下情况适用于函数、变量、方法、属性等:

  • 首字母大写的符号——包外可见
  • 首字母小写的符号——仅包内可见

结构类型的使用也非常简单:

1
2
3
4
5
6
7
8
9
10
// 定义并初始化一个结构
user := User{
ID: 112233,
Name: "philon",
}
// 或者
user := User{112233, "philon", "123456"}

// 修改属性
user.password = "56789"

类型的方法

根据面向对象的套路,定义了类型的属性,自然少不了要定义方法,但GO语言不允许直接把一个类型的方法定义在其内部,而是可以将其定义在任何其他地方。如果习惯了Java这种方式,可能会觉得十分别扭,但这正是GO类型灵活的地方。如果你觉得某个“业务对象”需要某个特殊的方法来处理,那就直接加上好了,不影响它的继承、耦合等问题。

给类型添加一个方法的基本语法为:

1
2
3
4
5
// u表示接收者,可以理解为面向对象中的一个对象
func (u User) method_name() {
u.name = "philon"
u.email = "xxx@xxx.com"
}

不过添加方法时需要注意“接受者”的区别,主要有两种:

  • 值接收者的方法在其内部修改对象的值,不改变外部调用者
  • 指针接收者的方法在其内部修改对象的值,改变外部调用者

还是以代码为例:

1
2
3
4
5
6
7
8
9
10
// 值接受者方法
func (u User) Auth(p Password) bool {
u.password = "123456" // 👈此行并不影响外部调用对象
return u.password == p
}

// 指针接受者方法
func (u *User) SetPassword(p Password) {
u.password = p // 👈同时修改了外部调用对象的属性
}

如果理解函数调用的内存管理,那这两种形式非常容易理解。调用函数的时候,传入的参数将拷贝一个副本并压栈,函数通过访问栈区来获取参数值。换句话说:所有传入函数的参数其实都只是副本,在函数内部修改副本的值,不会影响原始参数值。

✍️但务必注意✍️

Go语言里的引用类型:切片、映射、通道、接口和函数是比较特殊的,前几章已经说明了它们作为参数在函数间传递时,本身就是以引用形式传递,所以引用类型的方法,值接受者其实是个引用(指针)副本。千万小心。

嵌入类型(继承)

User类型的属性和方法都实现了,在面向对象里面自然少不了继承,例如管理员账户Administrator类型一般而言都会继承User。GO语言对继承的形式如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
// Administrator 管理员用户
type Administrator struct {
User // 通过嵌套,继承“父类”
Level int
}

// 使用方式
a := Administrator{
User: { 1, "root", "password" },
Level: 123
}
// 或者
var a Administrator
a.ID = 1
a.Name = "root"
a.Level = 123

接口

接口在第二章中其实总结了很多了,GO语言的接口属于鸭子类型——也就是一个类型只要实现了接口的方法,不管它们是否存在继承关系,都能够以多态的形式调用。

这里以Shower接口为例,该接口要求实现一个show方法,用于打印一个类型的内部信息。和面向对象的思路一样,各个类型实现自己的show方法,而Shower只负责调用。

首先是接口的定义:

1
2
3
4
5
6
7
8
9
10
// Shower 显示接口的定义
// 根据GO的规则,如果一个接口只有一个方法,那就叫方法名+er
type Shower interface {
show()
}

// ShowInfo 任何实现了show的类型都可以传入该函数
func ShowInfo(s Shower) {
s.show()
}

下面是User和Administrator的不同show实现:

1
2
3
4
5
6
7
8
9
10
11
12
13
// User类型实现show接口
func (u User) show() {
fmt.Printf("User %s<%d>\n", u.Name, u.ID)
}

// Administrator实现show接口
func (a Administrator) show() {
fmt.Printf("Administrator %s(%d): Level-%d\n", a.Name, a.ID, a.Level)
}

// 假设我们定义了两个类型的变量,并通过ShowInfo调用
ShowInfo(user) // User philon<112233>
ShowInfo(admin) // Administrator root(0): Level-123

从上边的例子可以看到,user和admin虽然是不同的类型,但是由于都实现了show这个接口方法,因此都可以传入ShowInfo函数,并且也实际调用到了它们各自的实现。

小结一下

  • type xxx struct 定义一个结构类型
  • type xxx interface 定义一个接口
  • 不管是类型、函数还是成员变量,首字母大写表示包外可见,否则包内可见
  • type xxx struct { OtherType }即可继承其它结构类型
  • func (t Type) foo() 定义一个类型的方法
  • 值接受者定义的类型方法,调用者传入副本,方法内修改对象不影响外部
  • 指针接受者定义的类型方法,调用者传入地址,方法内修改对象影响外部
  • 接口是实现多态的类型,只要实现了接口方法,任何类型都可以调用
  • 标识符首字母大写是包外公开,小写仅包内公开
0%